9 мин чтения ·
Дообучение LLM на своих данных: LoRA и QLoRA на арендованной GPU
Как подготовить датасет в формате chat JSONL, выбрать LoRA или QLoRA по памяти, обучить модель в Unsloth Studio и выгрузить её в GGUF для Ollama.
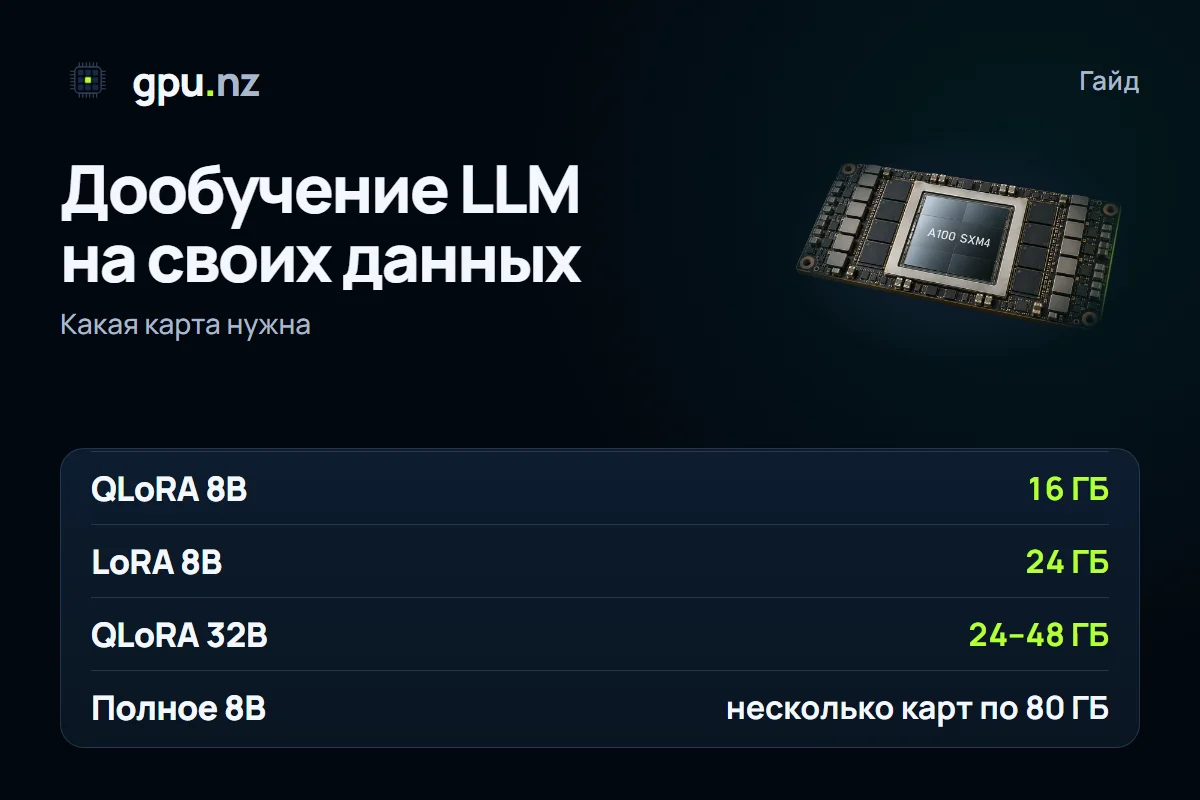
Дообучение (fine-tuning) — это донастройка уже обученной модели на ваших примерах: формата ответов, стиля или предметной области. Для моделей 7–8B обычно хватает LoRA или QLoRA на одной карте с 16–24 ГБ памяти. Полное дообучение требует нескольких GPU. На gpu.nz удобно начать с шаблона Unsloth Studio, а результат выгрузить в GGUF и запустить в Ollama.
Когда дообучать, а когда хватит промпта
- Дообучайте, если нужен стабильный формат ответа, особый стиль или узкая лексика, которые трудно описать одним промптом.
- Не дообучайте ради новых фактов. Знания надёжнее подавать через поиск по документам (RAG): дообучение передаёт модели манеру и формат, а запоминание фактов получается ненадёжным.
- Сначала попробуйте промпт и несколько примеров прямо в запросе. Переходите к дообучению, если результат стабильно не устраивает.
Откуда взять примеры
Самые полезные примеры — реальные: переписка службы поддержки, обращения клиентов, ответы экспертов, которые вы хотите воспроизвести. Они передают настоящий язык и настоящие ситуации. Если реальных данных мало, часть примеров можно написать вручную или сгенерировать другой моделью, но тогда каждый пример стоит проверить человеком: ошибки из черновика попадут в обучение.
Перед обучением уберите дубликаты, персональные данные и служебные строки, а также следите за балансом. Если 90% примеров про доставку и ни одного про возвраты, модель будет плохо отвечать на вопросы о возвратах. Отложите 5–10% примеров на проверку: они понадобятся в конце, для сравнения ответов.
Формат датасета: chat JSONL
Датасет — текстовый файл, где каждая строка — отдельный пример диалога в формате JSON. Такой вид принят в инструментах дообучения, в том числе в Unsloth. Каждый пример содержит список сообщений с ролями system, user и assistant, и последнее сообщение всегда от assistant.
{"messages": [{"role": "system", "content": "Ты помощник службы доставки."}, {"role": "user", "content": "Где мой заказ?"}, {"role": "assistant", "content": "Назовите номер заказа, и я проверю статус."}]}
{"messages": [{"role": "user", "content": "Можно поменять адрес?"}, {"role": "assistant", "content": "Да, если заказ ещё не передан курьеру. Напишите новый адрес."}]}
Проверьте файл скриптом до обучения. Он найдёт строки, которые не читаются как JSON, и примеры, где последнее сообщение не от модели.
import json

with open("train.jsonl", encoding="utf-8") as f:
    for n, line in enumerate(f, 1):
        msgs = json.loads(line)["messages"]
        if msgs[-1]["role"] != "assistant":
            raise SystemExit(f"строка {n}: последнее сообщение должно быть от assistant")
print("датасет корректен")
Сотни качественных примеров обычно заметно меняют формат и стиль, а для стабильного поведения в разных ситуациях нужны тысячи. Качество важнее количества: ошибки и однотипные ответы модель выучит так же быстро, как хорошие.
LoRA, QLoRA или полное дообучение
LoRA обучает небольшие адаптеры поверх замороженной модели. QLoRA делает то же, но базовую модель хранит в 4 битах, и памяти нужно заметно меньше. Полное дообучение меняет все веса: при смешанной точности на каждый параметр уходит около 16 байт — веса, градиенты и состояние оптимизатора. Подробный расчёт памяти под веса — в гайде сколько видеопамяти нужно для LLM.
| Метод | 8B | 14B | 32B | 70B |
|---|---|---|---|---|
| Полное дообучение | около 128 ГБ: несколько карт по 80 ГБ | около 224 ГБ: несколько карт по 80 ГБ | около 512 ГБ: серверный кластер | около 1,1 ТБ: кластер |
| LoRA, веса в 16 битах | около 16 ГБ весов: карта 24 ГБ | около 28 ГБ весов: карта 32–48 ГБ | около 64 ГБ весов: карта 80 ГБ | около 140 ГБ весов: две карты по 80 ГБ |
| QLoRA, веса в 4 битах | около 4–5 ГБ весов: карта 16 ГБ | около 7–9 ГБ весов: карта 16–24 ГБ | около 16–20 ГБ весов: карта 24–48 ГБ | около 35–43 ГБ весов: карта 48–80 ГБ |
Цифры — ориентиры для коротких примеров, до 2–4 тысяч токенов, с включённым gradient checkpointing. Длинные примеры и большой батч увеличивают расход памяти. Полное дообучение 7B с оптимизатором Adam требует около 112 ГБ, то есть две карты по 80 ГБ.
Unsloth Studio: пошаговый запуск
Шаблон открывает саму студию и TensorBoard, оба открываются кнопками на странице сервера. Шаги в студии идут в таком порядке: датасет, модель и метод, параметры, обучение, проверка и экспорт. Названия пунктов в вашей версии могут отличаться.
- Арендуйте сервер с картой из таблицы: для LoRA на 8B — 24 ГБ, для QLoRA на 8B — 16 ГБ.
- Загрузите train.jsonl через интерфейс студии или по SFTP.
- Выберите базовую модель (Qwen, Llama или Gemma) и метод: LoRA или QLoRA.
- Задайте параметры. Типичные стартовые значения: ранг LoRA 16, alpha 16, скорость обучения 2e-4, одна–три эпохи. Для длинных примеров уменьшите батч.
- Запустите короткий прогон на 50–100 шагах. Через TensorBoard проверьте, что функция потерь (loss) снижается, а память не упирается в предел карты.
- Запустите основное обучение, затем задайте модели вопросы, которых не было в датасете, и посмотрите ответы.
- Экспортируйте модель в GGUF с квантизацией q4_k_m или q8_0. Для Ollama нужен именно GGUF.
Параметры, которые влияют на результат
- Ранг LoRA (r) задаёт, сколько параметров получает адаптер. Больший ранг даёт больше ёмкости и требует больше памяти, но на небольшом датасете выигрыша от него часто нет.
- Alpha масштабирует вклад адаптера. Часто её выбирают равной рангу или вдвое больше.
- Скорость обучения определяет размер шага. Слишком высокая портит модель, слишком низкая учит медленно и требует больше эпох.
- Эпохи — число проходов по датасету. На малом датасете лишние эпохи ведут к переобучению: модель начинает повторять примеры дословно.
- Максимальная длина примера ограничивает память. Длинные диалоги нужно обрезать или разбивать.
- Размер батча и накопление градиентов задают, сколько примеров идёт в одном шаге. При нехватке памяти уменьшите батч и компенсируйте его накоплением градиентов.
Сколько времени занимает обучение
Время зависит от числа примеров, их длины, модели и карты. Оцените его сами: время одного шага умножьте на число шагов. Если шаг занимает 2 секунды, а шагов 1 000, обучение займёт около 33 минут. К этому добавьте загрузку модели и экспорт в GGUF, на которые уходят минуты.
Как снизить стоимость
- Прогоните маленький датасет на короткой задаче, чтобы поймать ошибки формата до основного обучения.
- Выбирайте QLoRA, если качество устраивает: карта с меньшим объёмом памяти стоит дешевле за минуту. Тарифы смотрите в каталоге.
- Сохраняйте чекпойнты каждые несколько сотен шагов. Прерываемые серверы дешевле, но их могут забрать, и тогда сохранения спасут прогресс. Подробнее — в гайде прерываемые серверы.
- Останавливайте сервер сразу после обучения: пока он остановлен, GPU не тарифицируется.
- Скачайте результат и удалите сервер. Диск платится как хранилище, пока сервер существует.
Что смотреть в TensorBoard
График функции потерь (loss) показывает, учится ли модель. Нормальная картина — плавное снижение, которое со временем выходит на плато. Если loss на обучении падает, а на отложенных примерах растёт, модель переобучается: остановитесь раньше или уменьшите число эпох. Если график не меняется совсем, проверьте формат датасета и шаблон чата: модель, скорее всего, видит не то, что вы хотели.
Экспорт в GGUF и запуск в Ollama
Ollama запускает модели в формате GGUF. Экспорт в студии сохраняет модель с выбранной квантизацией в один файл. Адаптер LoRA без базовой модели запускать в Ollama сложнее, поэтому проще экспортировать объединённую модель.
FROM ./support-model-q4_k_m.gguf
SYSTEM "Ты помощник службы доставки. Отвечай кратко."
PARAMETER temperature 0.7
ollama create support -f Modelfile
ollama run support "Где мой заказ?"Если ответы выглядят как набор случайных символов, модель не останавливается или повторяет одно и то же, проверьте шаблон чата. Он должен совпадать с тем, на котором обучали модель, а токен конца ответа (EOS) — быть правильным. Это самая частая причина плохого результата после экспорта.
Проверка качества
Отложите 20–50 примеров, которых не было в обучении, и сравните ответы базовой модели и дообученной. Если дообученная отвечает лучше на ваших примерах и не испортила общие ответы, модель готова. Если нет, уменьшите число эпох или скорость обучения и повторите запуск на том же датасете.
Дообучение окупается, когда задача повторяется: один и тот же формат нужен тысячам ответов. Для разовых задач проще промпт и поиск по документам. Если вам нужен сервер на время обучения, общая картина по задачам и нагрузкам — в решении для дообучения.
Вопросы и ответы
- Как дообучить LLM на своих данных?
- Подготовьте датасет в формате chat JSONL, арендуйте GPU с 16–24 ГБ, запустите Unsloth Studio, обучите LoRA или QLoRA и экспортируйте модель в GGUF для Ollama.
- Сколько видеопамяти нужно для дообучения модели?
- LoRA на 8B — около 16 ГБ весов, поэтому карта на 24 ГБ. QLoRA на 8B — около 4–5 ГБ весов, карта на 16 ГБ. Полное дообучение 7B с оптимизатором Adam — около 112 ГБ, то есть две карты по 80 ГБ.
- Что лучше для дообучения: LoRA или QLoRA?
- QLoRA экономит память и подходит, когда карта небольшая. Качество обычно близко к LoRA, но скорость на шаге у QLoRA обычно ниже из-за распаковки весов.
- Сколько стоит дообучение LLM?
- Это зависит от карты, числа примеров и шагов. Оцените время одного шага, умножьте его на число шагов, а полученное время — на минутную стоимость карты из каталога.
- Как запустить дообученную модель в Ollama?
- Экспортируйте её в GGUF, напишите Modelfile с FROM на этот файл, затем выполните ollama create имя -f Modelfile и ollama run имя.
- Можно ли дообучить модель без своей видеокарты?
- Да, на арендованном GPU. Сервер запускается за несколько минут, а платите вы только за время, пока сервер работает.