10 мин чтения ·
DeepSeek V4 Flash на своём сервере: сколько нужно GPU
DeepSeek V4 Flash в Q4 занимает 145,5 ГБ: 2 карты H200 или 4 карты по 80 ГБ. Таблица карт по квантизациям, контекст до 1M и запуск.
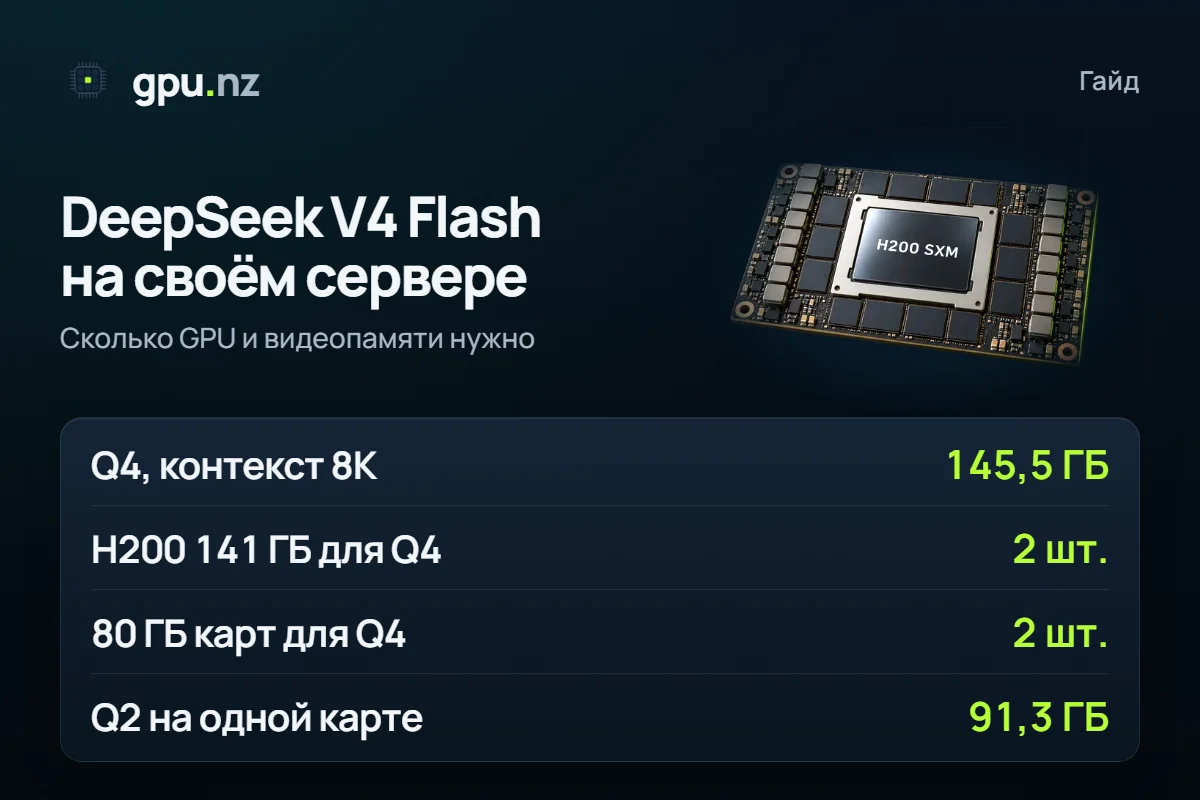
DeepSeek V4 Flash в Q4 занимает 145,5 ГБ видеопамяти (контекст 8K): потребуются 2 карты H200 по 141 ГБ или 4 карты по 80 ГБ с запасом. Одной картой обойтись можно: Q4 — на 180 ГБ, Q3 (121,5 ГБ) — на 141 ГБ, Q2 (91,3 ГБ) — на 96 ГБ, но впритык. Ниже — таблица «квантизация × карта», цена длинного контекста, калькулятор и запуск через vLLM и llama.cpp.
- Q4 (UD-Q4_K_XL), контекст 8K
- 145,5 ГБ
- Q4 (UD-Q4_K_XL), контекст 8K
- минимум карт H200 для Q4
- 2 × 141 ГБ
- минимум карт H200 для Q4
- Q2: помещается в одну карту на 96 ГБ, но впритык
- 91,3 ГБ
- Q2: помещается в одну карту на 96 ГБ, но впритык
- максимальный контекст, токенов: в Q4 он добавляет 12,1 ГБ
- 1M
- максимальный контекст, токенов: в Q4 он добавляет 12,1 ГБ
Что такое DeepSeek V4 Flash и чем она отличается от R1 и V3.2
DeepSeek V4 Flash — открытая модель DeepSeek, младшая в семействе V4 (старшая называется V4-Pro). По карточке модели лицензия MIT. Счётчик Hugging Face показывает 291 млрд параметров, контекст — до 1M токенов.
Это смесь экспертов (MoE): на каждый токен работают около 13 млрд параметров. Но в видеопамяти должны лежать все эксперты. Поэтому активные параметры обычно ускоряют ответ, а число нужных карт не уменьшают.
| V4 Flash | V3.2 | R1 | |
|---|---|---|---|
| Параметров, млрд (Hugging Face) | 291 | 685 | 685 |
| Активных на токен, млрд | 13 | 37 | 37 |
| Максимальный контекст | 1M | 160K | 160K |
| Кэш контекста на токен (оценка) | 12,5 КБ | 70,3 КБ | 70,3 КБ |
| Q4 при контексте 8K | 145,5 ГБ | 379,1 ГБ | 378,7 ГБ |
| Карт по 141 ГБ для Q4 | 2 | 4 | 4 |
| Карт по 80 ГБ для Q4 | 2 | 8 | 8 |
Для видеокарты главное отличие в размере. V4 Flash в 2,4 раза меньше по параметрам, в Q4 легче V3.2 и R1 в 2,6 раза, а её кэш контекста на токен меньше в 5,6 раза. Поэтому ей хватает 2–4 карт, а V3.2 и R1 в Q4 нужны 4–8 карт. Эти две модели и дистилляты R1 для одной небольшой карты разобраны в гайде про DeepSeek на своём сервере.
Сколько видеопамяти нужно DeepSeek V4 Flash
В Q4 — 145,5 ГБ, в Q3 — 121,5 ГБ, в Q2 — 91,3 ГБ при контексте 8K и одном запросе. Квантизация — сжатие весов: чем меньше бит на вес, тем меньше памяти и тем обычно заметнее потеря качества. Файлы GGUF здесь от unsloth: UD-Q4_K_XL (в калькуляторе он стоит на месте Q4_K_M), Q3_K_M и UD-Q2_K_XL. Общее правило расчёта — в гайде сколько видеопамяти нужно для LLM.
- V4 Flash145,5 ГБ
- V3.2685 млрд параметров379,1 ГБ
- R1685 млрд параметров378,7 ГБ
Оригинальные веса FP4/FP8 занимают 149,7 ГБ: по памяти это почти Q4, но без потерь на сжатии. Их запускает vLLM, а файлы GGUF — llama.cpp. Подробные размеры каждой версии — на странице DeepSeek V4 Flash.
Сколько GPU нужно: квантизация и размер карты
Веса и кэш делятся между картами поровну (тензорный параллелизм), а служебная память CUDA нужна на каждой. Мы берём наименьшее число карт из 1, 2, 4 и 8, при котором модель помещается. В ячейке — сколько карт такого размера нужно; прочерк — не хватает и восьми.
| Квантизация | 24 ГБ | 48 ГБ | 80 ГБ | 96 ГБ | 141 ГБ |
|---|---|---|---|---|---|
| Q2 UD-Q2_K_XL · 91,3 ГБ | 8 | 2 впритык | 2 | 1 впритык | 1 |
| Q3 Q3_K_M · 121,5 ГБ | 8 | 4 | 2 | 2 | 1 |
| Q4 UD-Q4_K_XL · 145,5 ГБ | 8 | 4 | 2 впритык | 2 | 2 |
| Оригинал FP4/FP8 · 149,7 ГБ | 8 | 4 | 2 впритык | 2 | 2 |
Пометка «впритык» — занято больше 92% памяти карты: модель запустится, но длинный запрос может не поместиться. Что видно из таблицы:
- Q4: 2 карты H200 (53% памяти каждой). На картах по 80 ГБ — 4 карты с запасом или 2 карты впритык.
- Q3: 1 карта H200 (88% памяти) или 2 карты по 80 ГБ.
- Q2: 1 карта на 96 ГБ, занято 98% памяти: короткий контекст и один запрос.
- Карты по 24 и 48 ГБ: Q4 помещается на 8 и 4 картах. Но чем больше карт, тем сильнее скорость зависит от связи между ними. Мы её не мерили.
Это расчёт по памяти. Рецепт vLLM для V4 Flash (recipes.vllm.ai) описывает раскладки на 4–8 карт для H200, B200, B300 и RTX PRO 6000. Для 8 × H100 там только отчёты сообщества, которые рецепт не подтверждает. Конфигурации на двух картах мы не запускали.
Что даёт сжатый кэш: контекст до 1M токенов
У большинства моделей кэш контекста растёт быстро: плотной R1 Distill Qwen 32B переход с 8K на 128K добавляет 30,0 ГБ. У V4 Flash кэш сжатый: по оценке калькулятора около 12,5 КБ на токен. Контекст 128K добавляет 1,4 ГБ, а весь миллион — 12,1 ГБ.
- V4 Flash, 128K1,4 ГБ
- V4 Flash, 1Mвесь контекст12,1 ГБ
- V3.2, 128Kсжатый кэш MLA8 ГБ
- R1 Distill Qwen 32B, 128Kплотная модель, обычный кэш30 ГБ
Эта цифра — оценка по архитектуре, не замер. В карточке модели DeepSeek называет сжатие кэша только для старшей V4-Pro: около 10% кэша V3.2 при миллионе токенов. Для Flash такой цифры нет. Из того же описания: внимание гибридное, из сжатого разреженного (CSA) и сильно сжатого (HCA).
Режим Think Max (максимальное рассуждение) DeepSeek советует запускать с контекстом от 384K токенов. Для V4 Flash в Q4 это 150,0 ГБ: всего на 4,5 ГБ больше, чем при 8K.
| Контекст | Кэш | Всего, Q4 | Карт по 80 ГБ | Карт по 141 ГБ |
|---|---|---|---|---|
| 8K | 0,10 ГБ | 145,5 ГБ | 2 впритык | 2 |
| 128K | 1,5 ГБ | 147,0 ГБ | 2 впритык | 2 |
| 384K | 4,6 ГБ | 150,0 ГБ | 2 впритык | 2 |
| 1M | 12,2 ГБ | 157,6 ГБ | 4 | 2 |
Миллион токенов в Q4 — 157,6 ГБ. Это по-прежнему 2 карты H200 или 4 карты по 80 ГБ.
Посчитайте свою конфигурацию
Выберите модель, квантизацию и длину контекста: калькулятор покажет память и серверы из каталога с нужным числом карт, самые дешёвые первыми. Контекст в нём доходит до 128K; миллион — в таблице выше.
Хватит ли одной видеокарты
Хватит, только если карта очень крупная. Q4 помещается в одну карту на 180 ГБ, Q3 — на 141 ГБ (H200), Q2 — на 96 ГБ. Карты на 80 ГБ и меньше не вмещают даже Q2.
Q2 на карте 96 ГБ — крайний случай. Контекст 128K он ещё вмещает (92,7 ГБ), а миллион — нет: тогда нужна карта на 141 ГБ. Качество Q2 мы не измеряли, поэтому проверьте его на своих задачах.
Серверы с несколькими картами одного типа ищите в каталоге: наличие меняется. Если нужного сервера нет, остаются Q2 на одной карте с коротким контекстом или другая модель. Для одной небольшой карты подойдут дистилляты R1: R1 Distill Qwen 32B в Q4 занимает 21,5 ГБ (карта на 24 ГБ), R1 0528 Qwen3 8B — 6,8 ГБ (карта на 8 ГБ). Это не V4: модели Qwen, обученные на рассуждениях R1.
Во сколько обойдётся час
Цена часа — число карт, умноженное на цену одной. Для Q4 это 2 карты H200 или 4 карты по 80 ГБ. Цены меняются каждую минуту, поэтому ниже живые карточки. Сервер с несколькими картами может стоить за карту немного дороже: точную цену покажет калькулятор выше.
Как запустить DeepSeek V4 Flash на арендованном сервере
Готового шаблона с этой моделью у нас нет, запуск ручной. Официальная карточка модели на Hugging Face даёт команды для vLLM и SGLang, а файлы GGUF для llama.cpp выпускает unsloth. vLLM подходит для API с параллельными запросами, llama.cpp — для файлов Q2–Q4 и одного пользователя. Поддержка V4 в обоих проектах новая и быстро меняется: берите свежие релизы.
Подключитесь по SSH
Команда подключения — на странице сервера. Шаблон сначала запустит свою модель по умолчанию; её мы сейчас заменим.
Замените модель на DeepSeek V4 Flash
В --tensor-parallel-size укажите число карт сервера, в --api-key — токен аренды. Флаги взяты из рецепта vLLM. Репозиторий не содержит шаблон чата, поэтому нужен --tokenizer-mode deepseek_v4.
pkill -f api_server nohup vllm serve deepseek-ai/DeepSeek-V4-Flash --host 0.0.0.0 --port 8000 \ --api-key <токен аренды> --tensor-parallel-size <число карт> --enable-expert-parallel \ --kv-cache-dtype fp8 --block-size 256 --trust-remote-code \ --tokenizer-mode deepseek_v4 --reasoning-parser deepseek_v4 \ --max-model-len 131072 > /var/log/vllm.log 2>&1 & tail -f /var/log/vllm.logДождитесь загрузки
Модель скачивается и компилируется: это дольше, чем у маленьких моделей. Сервер готов, когда в логе появится строка о запуске API.
Отправьте запрос
Адрес API — кнопка «API (порт 8000)» на странице сервера. Имя модели в запросе совпадает с аргументом vllm serve.
curl https://<id>-8000.run.gpu.nz/v1/chat/completions \ -H "Authorization: Bearer <токен>" \ -H "Content-Type: application/json" \ -d '{"model": "deepseek-ai/DeepSeek-V4-Flash", "messages": [{"role": "user", "content": "Привет"}]}'Остановите сервер, когда закончили
Оплата поминутная: остановленный сервер не тратит деньги на GPU, платите только за диск.
Для одного пользователя или меньшего числа карт соберите llama.cpp на шаблоне Ubuntu + CUDA и возьмите файл GGUF. llama.cpp сам делит слои между всеми видимыми картами:
apt-get update && apt-get install -y build-essential cmake git curl libcurl4-openssl-dev
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --target llama-server
./llama.cpp/build/bin/llama-server -hf unsloth/DeepSeek-V4-Flash-GGUF:UD-Q4_K_XL \
  --port 8080 -ngl 99 --ctx-size 32768
У шаблона Ubuntu нет веб-адресов, поэтому пробросьте порт по SSH с вашего компьютера и откройте http://localhost:8080:
ssh -p <порт> -L 8080:localhost:8080 root@<адрес>Что может пойти не так
- Версия vLLM. Рецепт требует vLLM 0.20.0 и новее. Берите релиз, а не ветку main: по руководству LMCache на ней V4 Flash не запускалась. Версию в шаблоне проверит команда python3 -c "import vllm; print(vllm.__version__)".
- Новая ревизия. Вышла и DeepSeek-V4-Flash-0731: счётчик Hugging Face показывает у неё 304 млрд параметров. Наши размеры — для основной версии, поэтому для 0731 берите запас по памяти.
- Параллельные запросы умножают кэш. Цифры выше — для одного запроса. В vLLM каждый одновременный запрос держит свой кэш, и vLLM по умолчанию занимает до 90% памяти карты. Для API выбирайте конфигурации без пометки «впритык».
- Скорость мы не мерили. Все цифры — расчёт по памяти. Скорость ответа зависит от числа карт и связи между ними, поэтому проверьте её на своём сервере, прежде чем вставлять модель в сервис.
Как мы считали
Веса — реальные размеры файлов на Hugging Face: GGUF из unsloth/DeepSeek-V4-Flash-GGUF и оригинал FP4/FP8 из deepseek-ai/DeepSeek-V4-Flash. Кэш контекста V4 Flash — оценка калькулятора, 12,5 КБ на токен; для V3.2 и R1 — 70,3 КБ по config.json. Служебная память — около 0,75 ГБ плюс буфер логитов на каждой карте. При нескольких GPU веса и кэш делятся поровну.
1 ГБ здесь — 1024³ байт, как у видеокарт, а Hugging Face показывает десятичные гигабайты: 160 ГБ вместо 148,7. Число параметров — по счётчику Hugging Face (карточка V4 Flash называет 284 млрд; у V3.2 и R1 счётчик включает вспомогательный модуль MTP, отсюда 685 вместо 671 млрд в названиях). Активные параметры, лицензия и совет по Think Max — из карточки модели, команды — из неё же, рецепта vLLM и документации unsloth. Данные на 2026-10-19; методика — в калькуляторе, сводная таблица по 35 моделям — в статье «Сколько видеопамяти нужно открытым LLM».
Вопросы и ответы
- Сколько видеопамяти нужно DeepSeek V4 Flash?
- В квантизации Q4 при контексте 8K — 145,5 ГБ, в Q3 — 121,5 ГБ, в Q2 — 91,3 ГБ. Оригинальные веса FP4/FP8 занимают 149,7 ГБ. Для Q4 нужна одна карта на 180 ГБ или несколько GPU.
- Сколько GPU нужно для DeepSeek V4 Flash?
- Для Q4 — 2 карты H200 по 141 ГБ или 4 карты по 80 ГБ с запасом. Для Q3 хватит одной H200, для Q2 — одной карты на 96 ГБ. Это расчёт по памяти для контекста 8K и одного запроса.
- Можно ли запустить DeepSeek V4 на одной видеокарте?
- Да, если карта крупная: Q4 помещается в 180 ГБ, Q3 — в 141 ГБ, Q2 — в 96 ГБ, и то впритык. Карты на 80 ГБ и меньше не вмещают даже Q2, там нужны несколько GPU.
- Чем DeepSeek V4 Flash отличается от DeepSeek R1 и V3.2?
- Она в 2,4 раза меньше по параметрам (291 против 685 млрд), держит контекст до 1M токенов вместо 160K и хранит кэш компактнее. В Q4 ей нужно 145,5 ГБ против 379,1 ГБ.
- Бесплатно ли запустить DeepSeek V4 Flash на своём сервере?
- Веса бесплатны: по карточке модели на Hugging Face лицензия MIT. Платить придётся за сервер с несколькими GPU: оплата поминутная, цена каждой карты видна в каталоге.
- Где запустить DeepSeek V4 Flash без своих видеокарт?
- Арендуйте сервер с несколькими видеокартами и запустите модель через vLLM или llama.cpp. Готового шаблона с V4 Flash нет, но шаблоны vLLM и Ubuntu + CUDA подходят. Остановили сервер — платите только за диск.


