8 мин чтения ·
Как запустить DeepSeek локально или на своём сервере
Полный DeepSeek R1 и V3 требуют сервера с несколькими GPU. Дистиллированные R1 от 1,5B до 70B работают на одной карте: таблица памяти, Ollama и API.
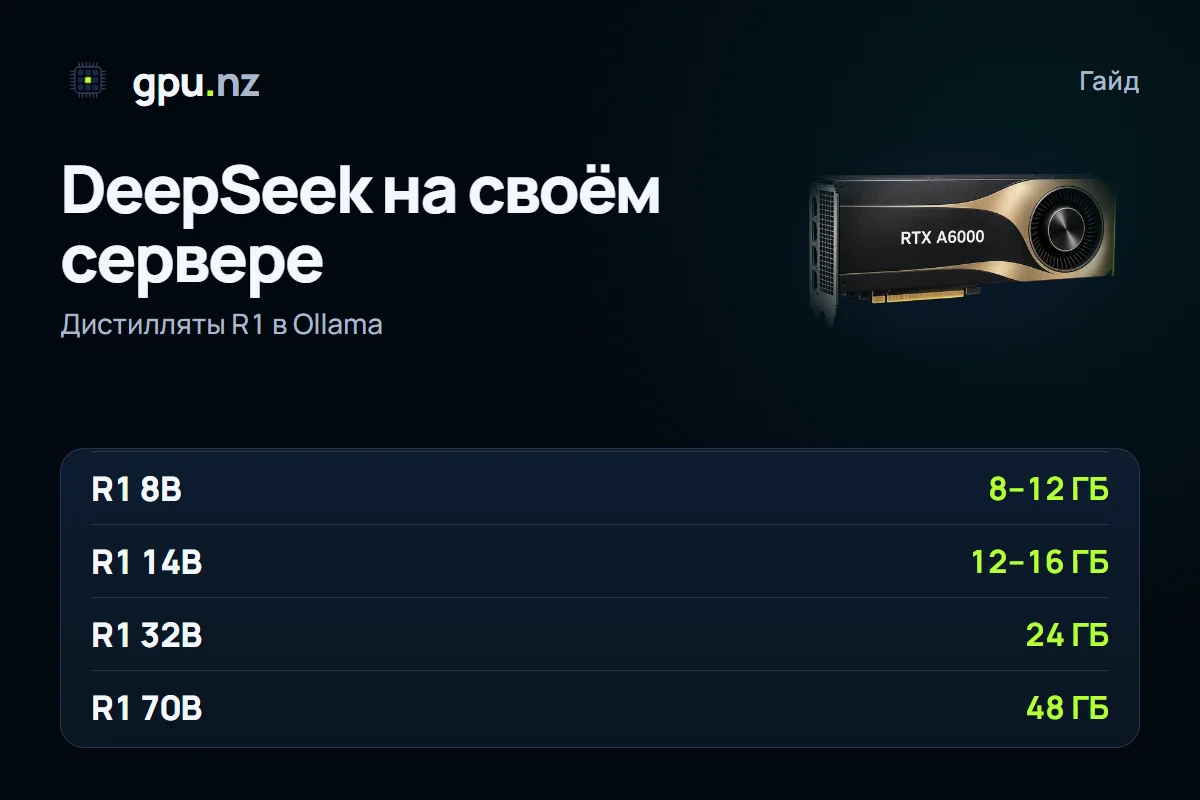
DeepSeek можно запустить двумя способами. Полные модели R1 и V3 весят 671 млрд параметров и требуют сервера с несколькими GPU даже в сжатом виде. Дистиллированные версии R1 — меньшие модели на 1,5–70 млрд параметров — работают на одной карте. Большинству задач хватает второго варианта: его ставят командой ollama pull deepseek-r1:8b или выбирают в шаблоне Open WebUI + Ollama на gpu.nz.
Что такое R1
R1 — модель, которую обучали развёрнуто рассуждать перед итоговым ответом. Именно поэтому она сильна в задачах, где важен ход решения, и именно поэтому отвечает дольше обычного чата. Версии R1 Distill перенесли этот навык на меньшие модели: их обучали на рассуждениях полной R1.
Лицензии у версий разные. Дистилляты, построенные на Qwen или Llama, подчиняются условиям лицензий этих моделей, поэтому перед коммерческим использованием читайте карточку той версии, которую берёте.
Какой вариант DeepSeek вам нужен
Дистилляты обучены на рассуждениях R1 поверх открытых моделей. Версии 1,5B, 7B, 14B и 32B построены на Qwen 2.5, тег 8b — на Qwen3 8B, а 70B — на Llama 3.3. Память в таблице указана для тегов Ollama в квантизации Q4 и для короткого контекста.
| Вариант | Тег Ollama | Файл | Видеопамять |
|---|---|---|---|
| R1, дистиллят 1,5B | deepseek-r1:1.5b | 1,1 ГБ | от 4 ГБ |
| R1, дистиллят 7B | deepseek-r1:7b | 4,7 ГБ | 8 ГБ впритык, лучше 12 ГБ |
| R1, дистиллят 8B, на Qwen3 8B | deepseek-r1:8b | 5,2 ГБ | 8–12 ГБ |
| R1, дистиллят 14B | deepseek-r1:14b | 9,0 ГБ | 12–16 ГБ |
| R1, дистиллят 32B | deepseek-r1:32b | 20 ГБ | 24 ГБ |
| R1, дистиллят 70B | deepseek-r1:70b | 43 ГБ | 48 ГБ, с запасом 80 ГБ |
| R1 полная, 671B | deepseek-r1:671b | 404 ГБ | сервер с несколькими GPU |
Дистиллированные модели рассуждают подробно: ответ часто начинается с длинного внутреннего рассуждения, и каждый токен занимает память. Поэтому для чата и задач на логику берите контекст 16 тысяч токенов и больше. Подробный расчёт памяти — в гайде сколько видеопамяти нужно для LLM.
Для каких задач DeepSeek полезен
Модели R1 сильнее всего там, где важен пошаговый ход решения: математика, логические задачи, отладка кода, разбор сложных текстов. Для коротких ответов, перевода и простого чата они часто избыточны, потому что модель тратит время на рассуждение там, где оно не нужно. Поэтому для повседневного чата выбирайте компактные модели, а R1 оставляйте для задач, где ответ надо проверять по шагам.
Почему полный DeepSeek не запускается на одной карте
Полные R1 и V3 — это 671 млрд параметров. Архитектура MoE использует на каждый токен около 37 млрд из них, но весь набор всё равно должен находиться в памяти. Файл в 4-битном формате занимает около 404 ГБ без учёта контекста, а исходный FP8-формат весит около 670 ГБ.
Значит, нужен сервер с несколькими GPU. Восемь карт H100 по 80 ГБ дают 640 ГБ суммарно: для 4-битной версии этого впритык, а с запасом под контекст нужны восемь H200 по 141 ГБ. Исходный FP8 потребует восемь H200 или B200. Такие конфигурации стоят дорого, поэтому для большинства задач разумнее взять дистиллят или API. Наличие нескольких GPU в одном сервере смотрите на страницах карт в каталоге: предложение меняется.
Можно ли обойтись без нескольких GPU? Технически можно: часть слоёв уходит в оперативную память, а веса читаются с диска. Но генерация при этом становится очень медленной, и для полной модели нужны сотни гигабайт оперативной памяти. Для экспериментов с самой моделью это вариант, для работы — нет. Если нужен параллельный API, дистилляты удобно поднимать в vLLM по той же схеме, что и Qwen: см. гайд Qwen API на своём сервере.
Запуск дистиллята на gpu.nz по шагам
- Выберите карту по таблице. Для 14B хватит 16 ГБ, для 32B нужна карта на 24 ГБ, для 70B — 48 ГБ и больше.
- Создайте сервер с шаблоном Open WebUI + Ollama. В поле «Модель» укажите deepseek-r1:14b или другой тег из таблицы.
- Дождитесь запуска. Чат откроется, когда модель загрузится: крупные теги скачиваются дольше.
- Откройте чат кнопкой «Открыть» или подключитесь по SSH и проверьте модель командой ollama ps.
ollama pull deepseek-r1:14b
ollama run deepseek-r1:14b
ollama ps
Ответ начинается с рассуждений модели. В интерфейсе Open WebUI они показываются отдельным блоком, в сыром выводе идут между тегами <think> и </think>. В коде отделяйте рассуждения от ответа, если пользователю нужен только итог. В карточке модели авторы советуют не добавлять системный промпт: все инструкции пишите в пользовательском сообщении, а температуру ставьте около 0,6.
Как измерить скорость на своей карте
Скорость зависит от карты, квантизации и длины ответа. Чтобы узнать её на своём сервере, запустите модель с флагом --verbose: после ответа Ollama покажет время и скорость генерации в токенах в секунду.
ollama run deepseek-r1:14b --verbose "Сколько будет 17 × 24?"Сравнивайте повторный запуск, а не первый: при первом обращении модель ещё загружается в видеопамять. Если скорость заметно ниже ожидаемой, проверьте ollama ps: доля CPU в колонке процессора замедляет генерацию.
Как вызвать API
Снаружи сервера ответы идут через защищённую ссылку с токеном, как и у других моделей Ollama. Запрос выглядит так:
curl https://<id>-11434.run.gpu.nz/api/chat -H "Authorization: Bearer <токен>" -d '{"model": "deepseek-r1:14b", "stream": false, "options": {"temperature": 0.6}, "messages": [{"role": "user", "content": "Реши: 17 × 24"}]}'В ответе будут и рассуждения, и итог. Если нужен только итог, в коде берите текст после закрывающего тега </think>. Другие модели Ollama и их размеры разобраны в гайде лучшие модели Ollama, а вызов API через vLLM — в гайде Ollama и vLLM на арендованном GPU.
Если в ответе есть блок рассуждений, отделите его в коде: возьмите текст после последнего закрывающего тега.
text = reply.choices[0].message.content
answer = text.split("</think>")[-1].strip()
print(answer)
Если сервер отдаёт рассуждения отдельным полем, этот разбор не нужен. Проверьте структуру первого ответа, прежде чем писать парсер.
Почему ответ долгий и что с этим делать
Рассуждения занимают больше токенов, чем короткий ответ, поэтому ответ идёт заметно дольше обычного чата. Это ожидаемо, а не сбой. Если модель обрывает рассуждение посередине, итогового ответа не будет: в API передайте в поле options параметр num_predict и задайте лимит длиннее обычного ответа.
Типичные ошибки при запуске
- Модель не помещается: ollama ps показывает долю CPU. Возьмите меньший тег или карту с большей памятью.
- Ответ обрывается на середине рассуждения: поднимите num_predict.
- Ответ пустой или странный: проверьте, что не добавлен системный промпт и что температура не выставлена слишком низкой, иначе модель может зацикливаться.
- Загрузка долгая: тег 70b весит около 43 ГБ, а полный R1 — около 404 ГБ. Запускайте pull в tmux или screen.
Дистиллят или полная модель
Для чата, кода и задач на логику хватает дистиллята 14B или 32B. Полная модель нужна, если вы исследуете её поведение или запускаете исходные веса на большом контексте и нагрузке. В остальных случаях дистиллят дешевле и быстрее: сначала проверьте его на своих задачах и только при нехватке качества переходите к большей модели.
Модели со временем меняются. Если вы ищете более новую версию DeepSeek, сверьте размер файла на странице модели в библиотеке Ollama: цифры этого гайда относятся к R1 и V3. Для большинства задач начните с deepseek-r1:8b или 14B на карте 12–16 ГБ, оцените ответы и переходите к 32B, если нужно больше качества. Полная модель на 671 млрд параметров — задача для кластера, а не для одной арендованной карты. Подробнее о выборе сервиса для LLM — в решении для LLM.
Вопросы и ответы
- Можно ли запустить DeepSeek R1 локально на обычном ПК?
- Полную модель — нет: в 4-битном формате она весит около 404 ГБ. Дистиллированные версии работают на ПК: 8B — с 8–12 ГБ видеопамяти, 14B — с 12–16 ГБ, 32B — с 24 ГБ.
- Как установить DeepSeek через Ollama?
- Командой ollama pull deepseek-r1:8b, затем ollama run deepseek-r1:8b. На gpu.nz то же делает шаблон Open WebUI + Ollama: тег указывается в поле «Модель».
- Сколько видеопамяти нужно для DeepSeek R1?
- Зависит от версии: 7B и 8B — около 5 ГБ в Q4, 14B — около 9 ГБ, 32B — около 20 ГБ, 70B — около 43 ГБ. Полная R1 в 4 битах занимает около 404 ГБ, то есть нужно несколько GPU.
- Чем DeepSeek R1 отличается от R1 Distill?
- R1 — полная модель на 671 млрд параметров. Distill — меньшие модели, которые обучили на рассуждениях R1 поверх Qwen или Llama. Их проще запустить, но в сложных задачах они обычно уступают полной модели.
- Почему DeepSeek пишет длинный ответ с тегом think?
- Модель сначала рассуждает — это её обычный режим работы. Итоговый ответ идёт после рассуждения. В интерфейсе блок можно свернуть, а в коде — отбросить.
- Можно ли сделать API DeepSeek на своём сервере?
- Да: Ollama отдаёт API на порту 11434 по защищённой ссылке с токеном. Адрес и токен берутся со страницы сервера.