8 мин чтения ·
Лучшие модели Ollama: что запустить на 8, 16, 24, 48 и 80 ГБ
Какие модели Ollama выбрать по объёму видеопамяти: теги, размеры файлов, квантизация, загрузка модели и вызов API. Qwen3, Gemma, Llama, DeepSeek R1.
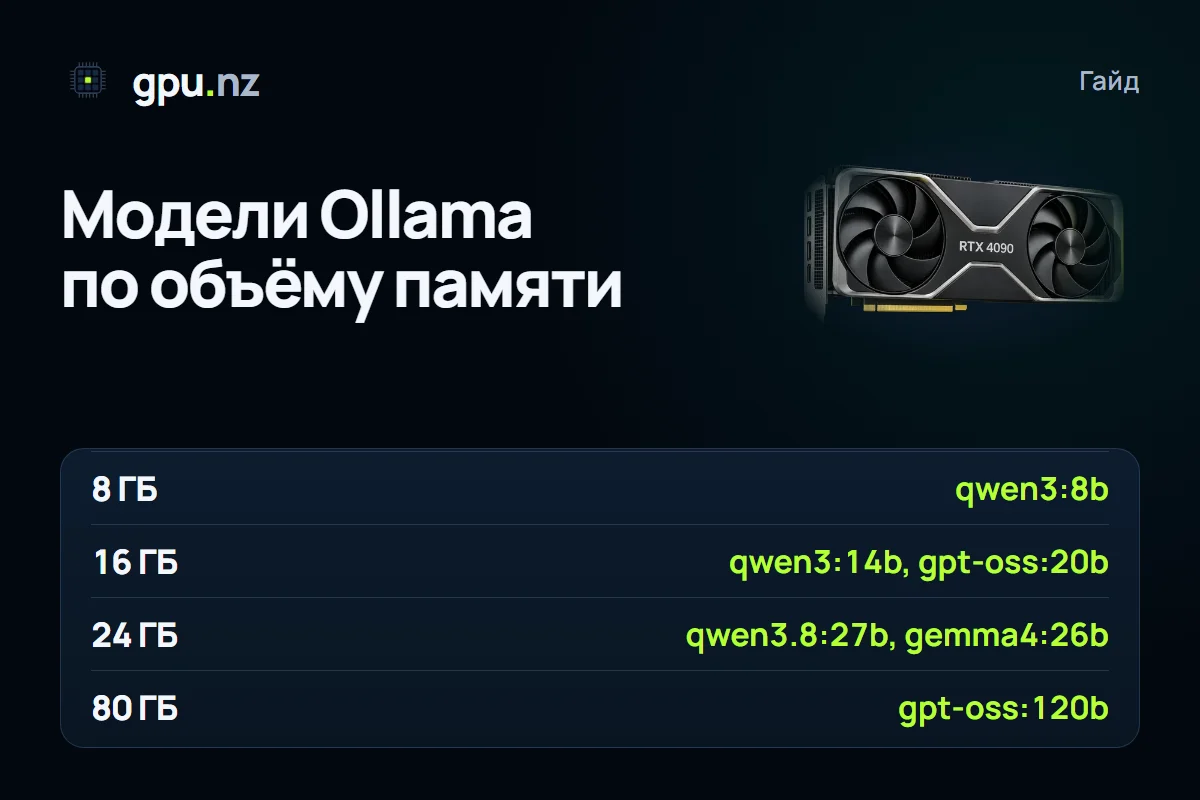
Выбирайте модель по видеопамяти: она определяет, какая модель помещается на карту целиком. Ниже подборка по пяти ступеням — 8, 16, 24, 48 и 80 ГБ. Каждая модель ставится одной командой ollama pull. На gpu.nz можно скачать модель в шаблоне Open WebUI + Ollama или назвать её в поле «Модель» при запуске: она загрузится при первом старте.
Как читать таблицу
Размеры в таблице — это файлы тегов из библиотеки Ollama. Квантизация тега написана в его описании, а размер файла показывает, насколько сильно сжаты веса. Реальный расход памяти выше примерно на 20% из-за контекста и служебных буферов, а длинный диалог добавляет память под KV-кэш. Поэтому карту берите с запасом. Подробный расчёт — в гайде сколько видеопамяти нужно для LLM.
В таблице есть две модели типа MoE (mixture of experts): qwen3:30b и mixtral:8x7b. В памяти у них лежат все параметры, но на каждый токен работает только часть, поэтому генерация быстрее, чем у плотной модели такого же объёма. Памяти всё равно нужна полная.
| Видеопамять | Тег Ollama | Файл | Для чего |
|---|---|---|---|
| 8 ГБ | qwen3:8b | 5,2 ГБ | универсальный чат на русском и английском, режим рассуждений |
| 8 ГБ | gemma3:4b | 3,4 ГБ | компактная модель, понимает картинки |
| 8 ГБ | qwen2.5-coder:7b | 4,7 ГБ | код и правки в проекте |
| 8 ГБ | llama3.1:8b | 4,9 ГБ | английский текст, инструкции, инструменты |
| 16 ГБ | qwen3:14b | 9,3 ГБ | тексты и рассуждения обычно сильнее, чем у 8B; запас под контекст |
| 16 ГБ | gemma3:12b | 8,2 ГБ | тексты и картинки |
| 16 ГБ | qwen2.5-coder:14b | 9,0 ГБ | код среднего объёма |
| 16 ГБ | deepseek-r1:14b | 9,0 ГБ | пошаговые рассуждения: математика, логика, код |
| 16 ГБ | gpt-oss:20b | 14 ГБ | открытая модель OpenAI, помещается с коротким контекстом |
| 24 ГБ | qwen3.8:27b | 18 ГБ | готовый чат Qwen 3.8 |
| 24 ГБ | gemma4:26b | около 18 ГБ | тексты и картинки, длинные документы |
| 24 ГБ | qwen3:30b | 19 ГБ | MoE: быстрая генерация при памяти на 30 млрд параметров |
| 24 ГБ | qwen3:32b | 20 ГБ | плотная модель для текста, кода и анализа |
| 24 ГБ | qwen2.5-coder:32b | 20 ГБ | сложный код и рефакторинг |
| 24 ГБ | deepseek-r1:32b | 20 ГБ | рассуждения на сложных задачах |
| 24 ГБ | gemma3:27b | 17 ГБ | картинки и длинные тексты |
| 24 ГБ | mistral-small:24b | 14 ГБ | универсальная модель средней величины для чата и инструментов |
| 48 ГБ | llama3.3:70b | 43 ГБ | длинные английские тексты и инструкции; на 48 ГБ впритык |
| 48 ГБ | deepseek-r1:70b | 43 ГБ | рассуждения в самом большом дистилляте |
| 48 ГБ | mixtral:8x7b | 26 ГБ | MoE на восемь экспертов, быстрый чат; на 24 ГБ не помещается |
| 80 ГБ | gpt-oss:120b | 65 ГБ | крупная открытая модель OpenAI на одной карте: GPT-OSS 120B |
Всё, что больше 80 ГБ в файле, требует двух карт или сервера с несколькими GPU. Например, qwen3:235b весит около 142 ГБ, и для неё понадобится конфигурация из нескольких карт.
Семейства моделей коротко
- Qwen3 — универсальная линейка с сильными многоязычными текстами и переключаемым режимом рассуждений. Размеры от компактных вариантов до 235B.
- Gemma 3 и Gemma 4 — модели Google. Варианты Gemma 3 от 4B и все варианты Gemma 4 понимают картинки.
- Llama 3.1 и 3.3 — английский текст, инструкции и вызов инструментов.
- DeepSeek R1 в дистиллированных версиях — модели для пошаговых рассуждений. Подробно о них — в гайде как запустить DeepSeek локально.
- gpt-oss — открытые модели OpenAI: 20B помещается в 16 ГБ, 120B — в одну карту на 80 ГБ.
- Qwen2.5-Coder — модели для кода: завершение, объяснение и правки.
- Mistral Small и Mixtral — компактная универсальная модель и MoE на восемь экспертов. Оба подходят для быстрого чата и инструментов.
Квантизация: какую версию брать
- Q4 — компромисс между памятью и качеством. Берите по умолчанию.
- Q8 — почти исходное качество, в полтора–два раза больше Q4. Имеет смысл, если памяти хватает с запасом.
- fp16 — полная точность, в три–четыре раза больше Q4. Для чата и кода обычно не нужна.
- Ниже 4 бит — экономия памяти ценой заметного падения качества. Для рабочих задач не рекомендуется.
Теги с суффиксами вроде q8_0 или fp16 обычно означают конкретную квантизацию. Прежде чем скачивать, проверьте описание тега в библиотеке.
Что внутри тега
Прежде чем тратить время на загрузку, посмотрите, что скрывается за тегом. Команда ollama show покажет архитектуру, число параметров, квантизацию и длину контекста по умолчанию.
ollama show qwen3:14bОбновить тег можно той же командой ollama pull: Ollama докачает только изменившиеся части. Когда тег больше не нужен, удалите его, и место на диске освободится.
Как выбрать модель за три шага
- Определите объём памяти карты и задачу: текст, код, картинки или рассуждения.
- Возьмите самый крупный тег из таблицы, который помещается с запасом под контекст. Для базового варианта берите Q4.
- Проверьте модель на 10–20 своих задачах. Если ответы устраивают, оставляйте её; если нет, переходите к более крупной модели или к другому семейству.
Такой подход быстрее, чем сравнивать названия. Размер в таблице говорит о памяти, но не о качестве: две модели одного размера могут заметно отличаться по языку и стилю ответов.
Как скачать модель
ollama pull qwen3:14b
ollama pull gemma3:12b
ollama list
ollama rm gemma3:12b   # освободить место на диске
На gpu.nz есть два пути. Первый — команда ollama pull в терминале сервера. Второй — поле «Модель» в форме запуска шаблона: название модели то же, что в Ollama, например qwen3:8b. Модель с Hugging Face ставится ссылкой вида hf.co/организация/репозиторий:Q4_K_M.
Как вызвать API
Ollama отдаёт REST API, а OpenAI-совместимые маршруты лежат в /v1. Снаружи сервера адрес — это защищённая ссылка вида https://<id>-11434.run.gpu.nz. Запрос несёт токен доступа с карточки сервера в заголовке Authorization.
curl https://<id>-11434.run.gpu.nz/api/chat -H "Authorization: Bearer <токен>" -d '{"model": "qwen3:14b", "stream": false, "think": false, "messages": [{"role": "user", "content": "Привет"}]}'Параметр think со значением false отключает размышления у моделей, которые их поддерживают, например Qwen3. Ответ приходит быстрее, но без пошагового разбора. Список установленных моделей отдаёт маршрут /api/tags.
Картинки на входе
Модели с поддержкой изображений, например Gemma 3 от 4B и Gemma 4, принимают картинку вместе с текстом. В API картинку передают в виде base64 в поле images сообщения. Текстовая модель ответа по картинке не даст, поэтому проверяйте, что тег поддерживает изображения.
curl https://<id>-11434.run.gpu.nz/api/chat -H "Authorization: Bearer <токен>" -d '{"model": "gemma3:12b", "stream": false, "messages": [{"role": "user", "content": "Что изображено на картинке?", "images": ["<картинка в base64>"]}]}'Контекст по умолчанию
Длина контекста задаётся переменной OLLAMA_CONTEXT_LENGTH. В шаблонах gpu.nz она выставлена так: 8 тысяч токенов в шаблоне Open WebUI + Ollama, 16 тысяч в большинстве готовых чатов и 32 тысячи у GPT-OSS 120B. Чем больше контекст, тем больше памяти занимает KV-кэш, поэтому увеличивайте его осознанно и следите за памятью командой ollama ps.
Типичные ошибки
- Модель не помещается: в колонке процессора у ollama ps появилась доля CPU. Возьмите меньшую квантизацию или карту с большей памятью.
- Загрузка зависает или обрывается: файлы весят десятки гигабайт. Запускайте ollama pull в tmux или screen.
- Ответы странные или пустые: проверьте, что выбран тег для чата, обычно это instruct-версия, а не базовая модель.
- Диск заполнен: модели занимают много места. Ненужные модели удаляйте командой ollama rm.
С чего начать
Если модель для вас новая, начните с 8 или 16 ГБ: на таких объёмах проще понять, какие задачи модель решает хорошо. Затем проверьте качество на своих примерах и только потом переходите к более крупной модели. Минуты на мощной карте стоят дороже, поэтому подбор по памяти экономит бюджет. Выбрать карту можно в каталоге GPU, а разбор запуска API есть в гайде Ollama и vLLM на арендованном GPU.
Вопросы и ответы
- Какая модель Ollama подойдёт для чата?
- Для карты на 8 ГБ — qwen3:8b, на 16 ГБ — qwen3:14b, на 24 ГБ — qwen3:32b или gemma3:27b. Универсального варианта нет: проверьте модели на своих задачах.
- Как скачать модель в Ollama?
- Командой ollama pull и названием тега, например ollama pull qwen3:14b. Список установленных моделей показывает ollama list. На gpu.nz модель можно назвать в поле «Модель» при запуске шаблона.
- Какая модель Ollama нужна для кода?
- Qwen2.5-Coder: тег 7b помещается в 8 ГБ, 14b — в 16 ГБ, 32b — в 24 ГБ. Для сложных задач берите самый крупный тег, который помещается на вашу карту.
- Сколько весит модель Ollama?
- Это зависит от размера и квантизации. Например, qwen3:8b — около 5 ГБ, llama3.3:70b — около 43 ГБ, gpt-oss:120b — около 65 ГБ. Точный размер указан на странице тега в библиотеке Ollama.
- Как подключить модель Ollama к своему приложению?
- Используйте REST API на порту 11434 или OpenAI-совместимый маршрут /v1. На gpu.nz адрес и токен берутся со страницы сервера, а токен передаётся в заголовке Authorization.
- Можно ли запустить модель с Hugging Face через Ollama?
- Да, если в репозитории есть файл GGUF. Команда выглядит как ollama pull hf.co/организация/репозиторий:Q4_K_M. Такой же адрес можно указать в поле «Модель» при запуске шаблона.