9 мин чтения ·
Какую модель Qwen выбрать: версии, размеры и видеопамять
Qwen3.5 9B занимает 6,8 ГБ, Qwen3.8 27B — 17,2 ГБ, Next 80B — 46,5 ГБ. Сравнение 11 моделей Qwen: размеры, контекст и видеокарта.
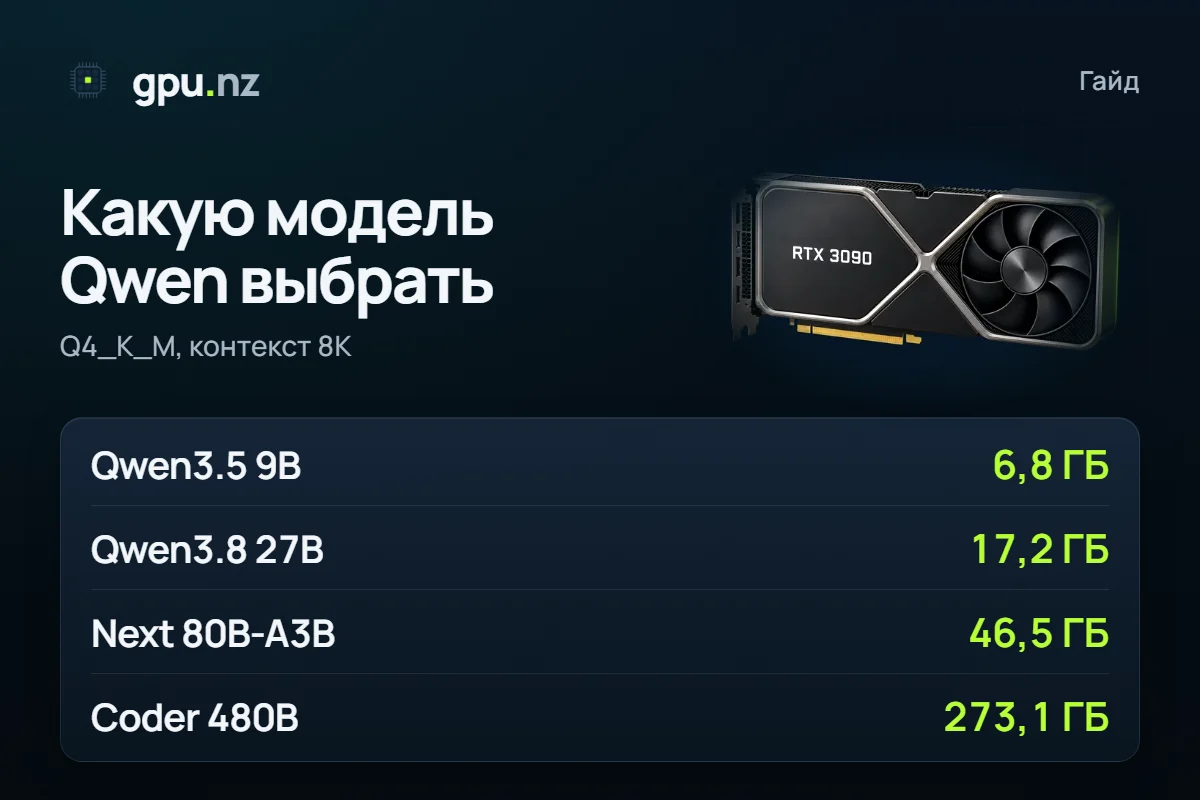
Какая модель Qwen запустится у вас, решает видеопамять. В квантизации Q4_K_M при контексте 8K Qwen3.5 9B занимает 6,8 ГБ, Qwen3.8 27B — 17,2 ГБ, Qwen3 Next 80B-A3B — 46,5 ГБ, а Qwen3 Coder 480B-A35B — 273,1 ГБ. Это расчёт для одного запроса по 11 моделям семейства из калькулятора gpu.nz. Дальше — чем отличаются поколения, какая модель подходит вашей карте и как запустить её на арендованной видеокарте.
- Qwen3.5 9B, Q4_K_M, контекст 8K
- 6,8 ГБ
- Qwen3.5 9B, Q4_K_M, контекст 8K
- Qwen3.8 27B, Q4_K_M, контекст 8K
- 17,2 ГБ
- Qwen3.8 27B, Q4_K_M, контекст 8K
- Qwen3 Next 80B-A3B, Q4_K_M, контекст 8K
- 46,5 ГБ
- Qwen3 Next 80B-A3B, Q4_K_M, контекст 8K
- контекст Qwen3.8, Qwen3.5, Next и Coder, токенов; у Qwen3 — 40K
- 256K
- контекст Qwen3.8, Qwen3.5, Next и Coder, токенов; у Qwen3 — 40K
Какие бывают модели Qwen
Qwen — открытые модели Alibaba. Названия путаются: версии, размеры и приписки идут вперемешку. Для видеокарты важны пять линеек из наших данных.
- Qwen3 — плотные модели на 8B, 14B и 32B и две модели MoE (смесь экспертов): 30B-A3B и 235B-A22B. Они работают с текстом и по умолчанию сначала рассуждают.
- Qwen3 Coder — модели для программирования, 30B-A3B и 480B-A35B. Авторы делали их для агентского кодинга, а режима рассуждений у них нет.
- Qwen3 Next 80B-A3B — MoE на 81,3 млрд параметров, из них на каждый токен работают 3 млрд. Внимание гибридное, о нём ниже.
- Qwen3.5 — в таблице версии 4B и 9B. Модели принимают картинки вместе с текстом.
- Qwen3.8 27B — самая новая в таблице. По описанию авторов, это следующее поколение после Qwen3.5 и Qwen3.6 с упором на код, профессиональные задачи и агентов. Принимает картинки и видео.
Буквы A3B и A22B читаются как «активных 3 и 22 млрд параметров». У плотных моделей работают все параметры.
Часть семейства в калькуляторе пока не учтена: у Qwen3.5 в библиотеке Ollama есть размеры 27b, 35b и 122b, у Qwen3.8 на Hugging Face — Flash-Next и 2.4T-A95B, а Qwen3.6 в данных нет. Эти модели мы не считаем.
Сколько видеопамяти нужно каждой модели Qwen
В квантизации Q4_K_M при контексте 8K — от 4,1 ГБ (Qwen3.5 4B) до 273,1 ГБ (Qwen3 Coder 480B-A35B). Квантизация — это сжатие весов: файл Q4_K_M у Qwen3.8 27B в 3,3 раза меньше оригинала BF16, а качество ответов почти не теряется. В сумму входят веса, кэш контекста (память под уже прочитанный текст) и служебная память CUDA.
- Qwen3.5 4B4,1 ГБ
- Qwen3.5 9B6,8 ГБ
- Qwen3 8B6,8 ГБ
- Qwen3 14B10,7 ГБ
- Qwen3.8 27B17,2 ГБ
- Qwen3 30B-A3BMoE19,1 ГБ
- Qwen3 Coder 30B-A3BMoE19,1 ГБ
- Qwen3 32B21,4 ГБ
- Qwen3 Next 80B-A3BMoE46,5 ГБ
Вся таблица семейства: параметры, вес файла, память при двух длинах контекста, минимальная карта и предел контекста по данным модели.
| Модель | Параметры | Веса Q4_K_M | Память при 8K / 32K | Минимальная карта | Предел контекста |
|---|---|---|---|---|---|
| Qwen3.5 4B | 4,7 млрд | 2,6 ГБ | 4,1 / 4,8 ГБ | 8 ГБ | 256K |
| Qwen3.5 9B | 9,7 млрд | 5,3 ГБ | 6,8 / 7,6 ГБ | 8 ГБ | 256K |
| Qwen3 8B | 8,2 млрд | 4,7 ГБ | 6,8 / 10,2 ГБ | 8 ГБ | 40K |
| Qwen3 14B | 14,8 млрд | 8,4 ГБ | 10,7 / 14,4 ГБ | 12 ГБ | 40K |
| Qwen3.8 27B | 27,8 млрд | 15,3 ГБ | 17,2 / 18,7 ГБ | 24 ГБ | 256K |
| Qwen3 30B-A3B | 30,5 млрд (3,3 млрд активных) | 17,3 ГБ | 19,1 / 21,3 ГБ | 24 ГБ | 40K |
| Qwen3 Coder 30B-A3B | 30,5 млрд (3,3 млрд активных) | 17,3 ГБ | 19,1 / 21,3 ГБ | 24 ГБ | 256K |
| Qwen3 32B | 32,8 млрд | 18,4 ГБ | 21,4 / 27,4 ГБ | 24 ГБ | 40K |
| Qwen3 Next 80B-A3B | 81,3 млрд (3 млрд активных) | 45,2 ГБ | 46,5 / 47,0 ГБ | 48 ГБ впритык | 256K |
| Qwen3 235B-A22B | 235 млрд (22 млрд активных) | 132,4 ГБ | 134,9 / 139,3 ГБ | 141 ГБ или 2 × 80 ГБ впритык | 40K |
| Qwen3 Coder 480B-A35B | 480 млрд (35 млрд активных) | 270,1 ГБ | 273,1 / 278,9 ГБ | 288 ГБ или 4 × 80 ГБ впритык | 256K |
Чем Qwen3.5 и Qwen3.8 отличаются от Qwen3
Главная разница видна в памяти: у новых моделей кэш контекста намного меньше. В Qwen3 все слои хранят весь разговор. В Qwen3.8 27B и Qwen3.5 9B (по карточкам моделей) три слоя из четырёх — линейное внимание Gated DeltaNet с маленьким состоянием. Кэш хранит только каждый четвёртый слой. На один токен выходит 64 КиБ против 256 КиБ у Qwen3 32B — в 4 раза меньше.
- Qwen3 32B6 ГБ
- Qwen3 14B3,8 ГБ
- Qwen3 8B3,4 ГБ
- Qwen3 30B-A3B2,3 ГБ
- Qwen3 Coder 30B-A3B2,3 ГБ
- Qwen3.8 27B1,5 ГБ
- Qwen3.5 4B0,8 ГБ
- Qwen3.5 9B0,8 ГБ
- Qwen3 Next 80B-A3B0,6 ГБ
Qwen3 Next устроен так же, как Qwen3.8, а Qwen3 Coder — как обычный Qwen3. На длинном контексте разница заметнее. Qwen3.8 27B с контекстом 128K занимает 24,7 ГБ и остаётся на карте 32 ГБ, а со всеми 256K — 32,7 ГБ и карте 48 ГБ. Qwen3 Coder 30B-A3B с 128K занимает 30,3 ГБ при весах 17,3 ГБ: кэш там обычный.
Контекст у новых моделей — 256K токенов, около 400 страниц текста. У Qwen3 в наших данных предел 40K. По карточкам Qwen3 его можно растянуть до 128K методом YaRN (растяжение контекста), но авторы предупреждают, что на коротких текстах качество может ухудшиться. Калькулятор такой режим не считает.
Для русского языка отдельных замеров у нас нет. Авторы заявляют поддержку более 100 языков у Qwen3 и 201 языка у Qwen3.5. Проверьте модель на своих текстах: на арендованной карте это час работы.
Какую модель Qwen взять под вашу видеокарту
Таблица показывает, какие модели добавляет каждая следующая ступень памяти при контексте 8K, 32K и 128K (Q4_K_M, один запрос). Прочерк значит, что новых моделей нет.
| Память карты | Что добавляется при 8K | При 32K | При 128K |
|---|---|---|---|
| 8 ГБ | Qwen3.5 4B, Qwen3.5 9B, Qwen3 8B | Qwen3.5 4B, Qwen3.5 9B | — |
| 12 ГБ | Qwen3 14B | Qwen3 8B | Qwen3.5 4B, Qwen3.5 9B |
| 16 ГБ | — | Qwen3 14B | — |
| 24 ГБ | Qwen3.8 27B, Qwen3 30B-A3B, Qwen3 Coder 30B-A3B, Qwen3 32B | Qwen3.8 27B, Qwen3 30B-A3B, Qwen3 Coder 30B-A3B | — |
| 32 ГБ | — | Qwen3 32B | Qwen3.8 27B, Qwen3 Coder 30B-A3B |
| 48 ГБ | Qwen3 Next 80B-A3B | — | — |
| 80 ГБ | — | Qwen3 Next 80B-A3B | Qwen3 Next 80B-A3B |
- 8 ГБ — Qwen3.5 9B: 6,8 ГБ при 8K и 7,6 ГБ при 32K. Qwen3 8B тоже помещается при 8K, а для 32K ему нужна карта 12 ГБ.
- 12 ГБ и 16 ГБ — Qwen3 14B: 10,7 ГБ при 8K. Для контекста 32K (14,4 ГБ) нужна карта 16 ГБ.
- 24 ГБ — самая широкая ступень: Qwen3.8 27B (17,2 ГБ), Qwen3 30B-A3B и Coder 30B-A3B (19,1 ГБ), Qwen3 32B (21,4 ГБ). Контекст 32K держат все, кроме Qwen3 32B.
- 32 ГБ — Qwen3 32B с контекстом 32K (27,4 ГБ) и Qwen3.8 27B с контекстом 128K (24,7 ГБ).
- 48 ГБ — Qwen3 Next 80B-A3B: 46,5 ГБ, то есть почти вся карта. Контекст 32K уже не помещается, для него нужна карта 80 ГБ.
Внутри одной линейки больше параметров обычно значит сильнее ответы. Сравнения качества между линейками у нас нет: возьмите две-три модели, которые помещаются, и прогоните на своих задачах.
Посчитайте свою конфигурацию
Выберите модель, квантизацию и длину контекста — калькулятор покажет память и видеокарты из каталога, на которых модель запустится дешевле всего.
Что выбрать для кода, чата и картинок
- Код в редакторе и агенты — Qwen3 Coder. Версия 30B-A3B занимает 19,1 ГБ и работает на карте 24 ГБ; 480B-A35B требует несколько карт.
- Чат, тексты, анализ — Qwen3.8 27B (24 ГБ) или Qwen3.5 9B на карте поменьше. Рассуждения у них включены по умолчанию.
- Картинки на входе — Qwen3.5 и Qwen3.8: можно приложить фото или скриншот. У Qwen3 и Coder вход только текстовый.
- API для нескольких человек — модели MoE вроде 30B-A3B и Next: на токен работает меньше параметров, чем у плотной модели того же размера. Для такого API подойдёт vLLM.
- Генерация картинок — это другое семейство, Qwen-Image. Установка и работа — в статье Qwen-Image-Edit в ComfyUI.
- Версии без отказов — готовые шаблоны Qwen3.8 27B без цензуры (карта 24 ГБ) и Qwen3 14B без цензуры (карта от 12 ГБ).
Сколько видеокарт нужно Qwen3 235B и Coder 480B
Большие модели не помещаются в обычную карту. Qwen3 235B-A22B в Q4_K_M занимает 134,9 ГБ: это почти вся карта 141 ГБ. Qwen3 Coder 480B-A35B — 273,1 ГБ: одна карта 288 ГБ или несколько карт поменьше.
| Модель | Веса Q4_K_M | Память при 8K | Одна карта | Карты по 80 ГБ | Карты по 141 ГБ |
|---|---|---|---|---|---|
| Qwen3 Next 80B-A3B | 45,2 ГБ | 46,5 ГБ | 48 ГБ | 80 ГБ | 141 ГБ |
| Qwen3 235B-A22B | 132,4 ГБ | 134,9 ГБ | 141 ГБ | 2 × 80 ГБ | 141 ГБ впритык |
| Qwen3 Coder 480B-A35B | 270,1 ГБ | 273,1 ГБ | 288 ГБ | 4 × 80 ГБ | 2 × 141 ГБ впритык |
Модель делится между картами: в расчёте веса и кэш пополам, а служебная память есть на каждой. Серверы с несколькими картами есть в каталоге не всегда. Калькулятор выше показывает только те, что доступны сейчас.
Как запустить Qwen на арендованной видеокарте
Нет подходящей карты — арендуйте сервер на время работы. Для Qwen3.8 27B есть готовый шаблон с чатом и API, остальные модели ставит Ollama.
Выберите карту по таблице выше
Для Qwen3.8 27B нужна карта на 24 ГБ: RTX 3090 или RTX 4090 из каталога. Для Qwen3.5 9B хватит 8 ГБ.
Выберите шаблон
Для Qwen3.8 27B — шаблон Qwen 3.8: модель, чат и API готовы без настройки. Для остальных — Open WebUI + Ollama: впишите тег в поле «Модель», например qwen3.5:9b, qwen3:14b или qwen3-coder:30b.
Подождите 2–5 минут
Сервер запускается, а модель скачивается при первом старте. Большим моделям нужно больше времени.
Откройте чат
Кнопка Open WebUI на странице сервера открывает чат. API в формате OpenAI работает на том же сервере, примеры запросов — в статье Qwen API на своём сервере.
Добавьте другую модель, если нужно
Скачайте её в чате или по SSH, не создавая новый сервер.
ollama pull qwen3.5:9bОстановите сервер, когда закончили
Оплата поминутная: остановленный сервер не тратит деньги на GPU, платите только за диск.
Большим моделям и API для нескольких пользователей подойдёт vLLM. Так запускается Qwen3 Next 80B-A3B по карточке модели: четыре карты, контекст 256K, нужен vLLM 0.10.2 или новее.
vllm serve Qwen/Qwen3-Next-80B-A3B-Instruct --port 8000 --tensor-parallel-size 4 --max-model-len 262144Флаг --tensor-parallel-size задаёт число карт, --max-model-len — длину контекста. Шаблон по умолчанию запускает другую модель; как сменить её и не оставить API без ключа — на странице шаблона.
Что может пойти не так
- Рассуждения занимают контекст. Qwen3, Qwen3.5 и Qwen3.8 по умолчанию сначала думают, и длинные размышления растят кэш. У Qwen3 и Qwen3.5 их можно отключить параметром enable_thinking=False. У Coder рассуждений нет.
- Параллельные запросы умножают кэш. Цифры выше — для одного запроса. В vLLM каждый одновременный запрос держит свой кэш, поэтому для API на нескольких человек нужен запас.
- Карта впритык. Если модель занимает больше 92% памяти карты, она запустится, но длинный разговор не поместится. В таблице так отмечены Qwen3 Next 80B-A3B, Qwen3 235B-A22B и Qwen3 Coder 480B-A35B.
- Теги Ollama — другие сборки. Размер тега в библиотеке Ollama немного отличается от файла GGUF Q4_K_M в наших данных. Если расчёт впритык, берите карту следующей ступени.
- Лицензии разные. На карточках Qwen3.8 27B, Qwen3.5 9B, Qwen3 32B и 235B, Next и Coder указана Apache-2.0, а у Qwen3.8 Flash-Next — qwen-community-1.0. Перед коммерческим запуском откройте карточку нужной модели.
Как мы считали
Веса — реальные размеры файлов: GGUF с Hugging Face, BF16 — из оригинальных репозиториев Qwen. Кэш контекста посчитан по config.json каждой модели с учётом линейных слоёв гибридных моделей. Служебная память — около 0,75 ГБ плюс буфер логитов. Карту считаем подходящей, если модель занимает не больше 97,5% её памяти. 1 ГБ здесь — 1024³ байт, как у видеокарт. Данные на 2026-10-19; методика — в калькуляторе, сводная таблица по 35 моделям — в статье «Сколько видеопамяти нужно открытым LLM». Теги Ollama по ступеням памяти — в подборке моделей Ollama, а соседняя по теме — Gemma 4: какая версия подойдёт.
Вопросы и ответы
- Сколько видеопамяти нужно Qwen3.8 27B?
- В квантизации Q4_K_M с контекстом 8K — 17,2 ГБ, поэтому нужна карта на 24 ГБ. С контекстом 128K модель занимает 24,7 ГБ и требует карты на 32 ГБ.
- Какая модель Qwen запустится на 8 ГБ видеопамяти?
- Qwen3.5 9B (6,8 ГБ), Qwen3 8B (6,8 ГБ) и Qwen3.5 4B (4,1 ГБ) при контексте 8K. На 32K из них остаются Qwen3.5: у Qwen3 8B кэш растёт быстрее, и ему уже нужна карта 12 ГБ.
- Что значит A3B в названии Qwen?
- Около трёх миллиардов активных параметров. Модель устроена как смесь экспертов: на каждый токен работает малая часть весов, поэтому она быстрее плотной модели того же размера. В видеопамять при этом загружаются все веса: Qwen3 30B-A3B занимает 19,1 ГБ, как плотная модель на 30B.
- Чем Qwen3.8 и Qwen3.5 отличаются от Qwen3?
- У них гибридное внимание: три слоя из четырёх хранят лишь маленькое состояние, поэтому кэш контекста на токен в 4 раза меньше, чем у Qwen3 32B. Контекст у новых моделей — 256K против 40K, и они принимают картинки. Сравнения качества мы не проводили.
- Какую модель Qwen выбрать для программирования?
- Для кода у Qwen есть линейка Coder: 30B-A3B (19,1 ГБ, карта 24 ГБ) и 480B-A35B (273,1 ГБ, несколько карт). По карточкам, они рассчитаны на агентский кодинг и работают без рассуждений. Универсальную Qwen3.8 27B тоже стоит проверить на своих задачах.
- Где скачать Qwen и как запустить без своей видеокарты?
- Веса лежат на Hugging Face в организации Qwen, например Qwen/Qwen3.8-27B, а в Ollama хватит команды ollama run qwen3.8:27b. Своей карты нет — арендуйте сервер на 24 ГБ с шаблоном «Qwen 3.8»: чат и API откроются через 2–5 минут.


