7 мин чтения ·
Gemma 4: сколько видеопамяти нужно и какую видеокарту взять
Gemma 4 12B работает на карте 12 ГБ, 26B-A4B и 31B — на 24 ГБ в Q4. Видеопамять по квантизациям, контекст до 256K и подбор видеокарты.
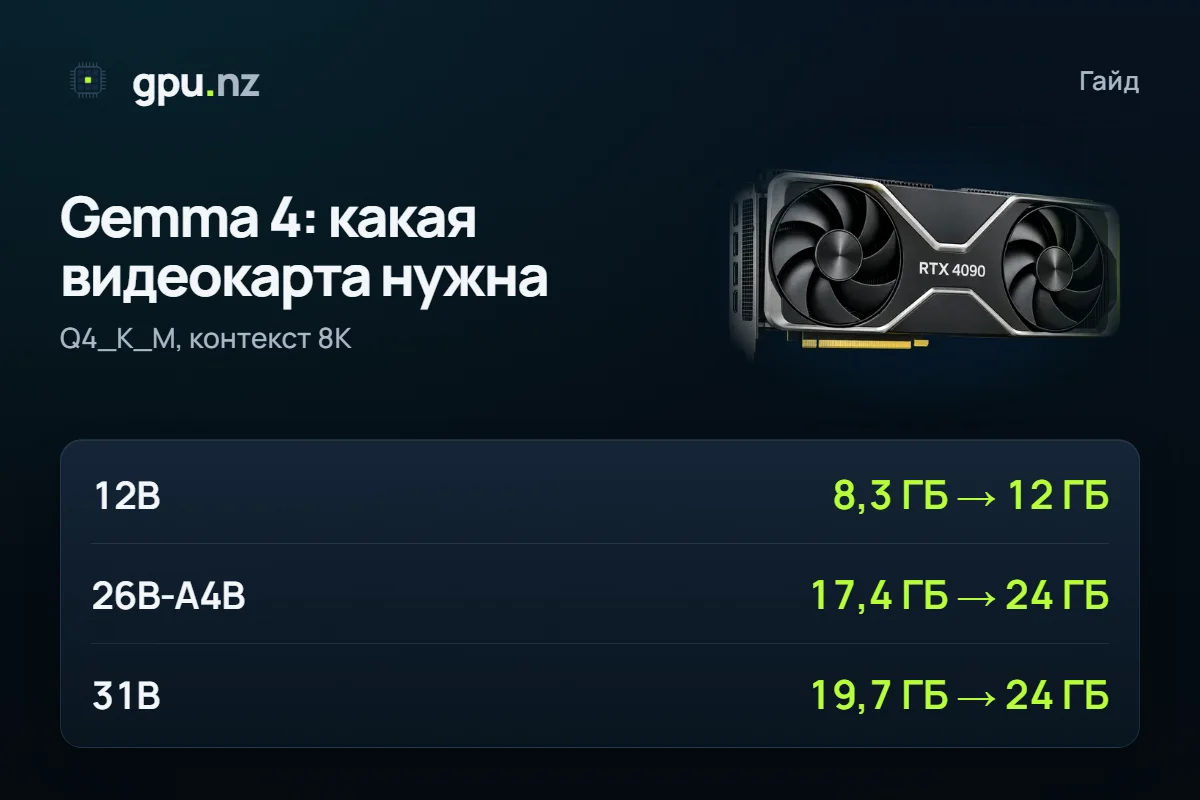
Gemma 4 12B в квантизации Q4_K_M с контекстом 8K занимает 8,3 ГБ видеопамяти и работает на карте 12 ГБ. Gemma 4 26B-A4B и 31B в той же квантизации — 17,4 ГБ и 19,7 ГБ, им нужна карта 24 ГБ. Цифры посчитаны по реальным файлам моделей и их архитектуре; ниже — таблица по квантизациям, калькулятор и совет, какую версию брать.
- Gemma 4 12B, Q4_K_M, контекст 8K
- 8,3 ГБ
- Gemma 4 12B, Q4_K_M, контекст 8K
- Gemma 4 26B-A4B, Q4_K_M, контекст 8K
- 17,4 ГБ
- Gemma 4 26B-A4B, Q4_K_M, контекст 8K
- Gemma 4 31B, Q4_K_M, контекст 8K
- 19,7 ГБ
- Gemma 4 31B, Q4_K_M, контекст 8K
- максимальный контекст всех трёх версий, токенов
- 256K
- максимальный контекст всех трёх версий, токенов
Какие версии Gemma 4 есть
Gemma 4 — открытые модели Google. Для видеокарты интересны три версии, и все три понимают картинки: им можно отправить фото, скриншот или схему вместе с вопросом.
- Gemma 4 12B — плотная модель на 11,96 млрд параметров. Самая лёгкая: помещается в игровые карты на 12 ГБ.
- Gemma 4 26B-A4B — модель MoE (смесь экспертов): всего 25,81 млрд параметров, но на каждый токен работают около 4 млрд. Буквы A4B так и читаются: 4 млрд активных.
- Gemma 4 31B — старшая плотная модель на 31,27 млрд параметров: на каждый токен работают все.
Есть и совсем маленькие версии для телефонов и ноутбуков, но в этой статье — те, ради которых нужна видеокарта.
Сколько видеопамяти нужно Gemma 4
В самой популярной квантизации Q4_K_M — от 8,3 ГБ до 19,7 ГБ при контексте 8K. Квантизация — это сжатие весов: Q4_K_M хранит около 4,8 бита на параметр вместо 16 в исходной версии BF16 и почти не теряет в качестве ответов. В сумму входят веса модели, кэш контекста и служебная память CUDA.
- Gemma 4 12B8,3 ГБ
- Gemma 4 26B-A4B17,4 ГБ
- Gemma 4 31B19,7 ГБ
- Gemma 3 27Bпрошлое поколение17,7 ГБ
Полная таблица: сколько памяти нужно каждой версии в четырёх квантизациях и какая карта для этого минимальна. Q8_0 почти не отличается от оригинала, BF16 — сам оригинал, Q3_K_M — компромисс для карт, где Q4 не помещается.
| Версия | Q3_K_M | Q4_K_M | Q8_0 | BF16 |
|---|---|---|---|---|
| Gemma 4 12B | 7,0 ГБ карта 8 ГБ | 8,3 ГБ карта 12 ГБ | 13,5 ГБ карта 16 ГБ | 23,9 ГБ карта 32 ГБ |
| Gemma 4 26B-A4B | 13,5 ГБ карта 16 ГБ | 17,4 ГБ карта 24 ГБ | 26,6 ГБ карта 32 ГБ | 48,6 ГБ карта 80 ГБ |
| Gemma 4 31B | 16,4 ГБ карта 24 ГБ | 19,7 ГБ карта 24 ГБ | 33,1 ГБ карта 48 ГБ | 59,9 ГБ карта 80 ГБ |
Почему длинный контекст почти ничего не стоит
У Gemma 4 большинство слоёв помнят только последние 1024 токена (это называется скользящим окном), и лишь часть слоёв хранит весь разговор. Поэтому кэш контекста растёт медленно: переход с 8K на 128K токенов добавляет несколько гигабайт, а не десятки, как у обычной плотной модели.
- Gemma 4 12B1,9 ГБ
- Gemma 4 26B-A4B2,3 ГБ
- Gemma 4 31B9,4 ГБ
- DeepSeek R1 Distill Qwen 32Bполное внимание на всех слоях30 ГБ
На практике это значит, что Gemma 4 26B-A4B даже с контекстом 128K (около 200 страниц текста) занимает 19,7 ГБ и остаётся на карте 24 ГБ. Gemma 4 31B держит 32K в 24 ГБ (21,6 ГБ), а для 128K ей нужна карта 32 ГБ.
Посчитайте свою конфигурацию
Выберите версию, квантизацию и длину контекста — калькулятор покажет память и видеокарты из каталога, на которых модель запустится дешевле всего.
26B-A4B или 31B: что выбрать
Обе модели требуют карту 24 ГБ, но работают по-разному. 26B-A4B на каждый токен задействует около 4 млрд параметров из 26, поэтому отвечает заметно быстрее. Памяти ей нужно столько же, сколько плотной модели её размера: загружены должны быть все эксперты, даже если в шаге работают не все.
- 26B-A4B — чат и API, где важна скорость ответа и несколько запросов сразу; длинные документы на карте 24 ГБ.
- 31B — когда нужна старшая плотная модель и не страшно, что ответы идут медленнее. Перед выбором проверьте обе на своих задачах: на арендованной карте это час работы.
- 12B — карты на 12–16 ГБ, быстрые ответы, эксперименты с картинками и текстом без большого бюджета.
Если у вас карта на 16 ГБ, 26B-A4B можно запустить в Q3_K_M: это 13,5 ГБ при контексте 8K, карта 16 ГБ. Качество ответов у Q3 ниже, чем у Q4, поэтому для серьёзной работы лучше 24 ГБ.
Какая видеокарта нужна для Gemma 4
Минимальная карта для каждой версии и квантизации при контексте 8K. Для длинного контекста и нескольких одновременных запросов берите следующую ступень памяти.
| Память карты | Что запустится (контекст 8K) |
|---|---|
| 8 ГБ | 12B Q3_K_M |
| 12 ГБ | 12B Q4_K_M |
| 16 ГБ | 12B Q8_0, 26B-A4B Q3_K_M |
| 24 ГБ | 26B-A4B Q4_K_M, 31B Q3_K_M, 31B Q4_K_M |
| 32 ГБ | 12B BF16, 26B-A4B Q8_0 |
| 48 ГБ | 31B Q8_0 |
| 80 ГБ | 26B-A4B BF16, 31B BF16 |
Как запустить Gemma 4 на арендованной видеокарте
Своей подходящей карты нет — арендуйте сервер с видеокартой на время работы. Для 26B-A4B есть готовый шаблон с чатом и API.
Выберите карту на 24 ГБ и шаблон «Gemma 4 26B»
В каталоге подойдут RTX 3090, RTX 4090 или RTX A5000. Нажмите «Арендовать» и выберите шаблон Gemma 4 26B.
Подождите 2–5 минут
Сервер запускается, а модель (около 17 ГБ) скачивается при первом старте.
Откройте чат
Кнопка Open WebUI на странице сервера открывает чат. Прикрепите картинку к сообщению и спросите, что на ней.
Подключите API, если нужно
API совместим с OpenAI: адрес из кнопки «Ollama API», модель gemma4:26b, токен со страницы сервера.
curl "https://<id>-11434.run.gpu.nz/v1/chat/completions" \ -H "Authorization: Bearer <токен>" \ -H "Content-Type: application/json" \ -d '{"model": "gemma4:26b", "messages": [{"role": "user", "content": "Привет!"}]}'Остановите сервер, когда закончили
Оплата поминутная: остановленный сервер не тратит деньги на GPU, платите только за диск.
Gemma 4 12B и 31B запускаются в шаблоне Ollama из файлов GGUF на Hugging Face (репозитории unsloth/gemma-4-12B-it-GGUF и unsloth/gemma-4-31B-it-GGUF):
ollama run hf.co/unsloth/gemma-4-31B-it-GGUF:Q4_K_MДля API на несколько пользователей подойдёт vLLM с оригинальными весами google/gemma-4-31B-it — им нужна карта на 80 ГБ.
Что может пойти не так
- Картинки занимают контекст. Несколько крупных снимков в одном диалоге быстро его заполняют. Для новой серии изображений начинайте новый чат.
- Параллельные запросы умножают кэш. Цифры выше — для одного запроса. В vLLM каждый одновременный запрос держит свой кэш контекста, поэтому для API на несколько человек нужен запас.
- Карта впритык. Если модель занимает больше 92% памяти, она запустится, но длинный разговор или крупная картинка могут не поместиться. Калькулятор отмечает такие карты словом «впритык».
Как мы считали
Веса — реальные размеры файлов: GGUF из репозиториев unsloth на Hugging Face, BF16 — из оригинальных репозиториев google. Кэш контекста посчитан по config.json каждой модели с учётом скользящего окна. Служебная память — около 0,75 ГБ плюс буфер логитов. 1 ГБ здесь — 1024³ байт, как у видеокарт. Данные на 2026-10-19; методика — в калькуляторе, сводная таблица по 35 моделям — в статье «Сколько видеопамяти нужно открытым LLM».
Вопросы и ответы
- Сколько видеопамяти нужно Gemma 4?
- В квантизации Q4_K_M с контекстом 8K: 12B — 8,3 ГБ, 26B-A4B — 17,4 ГБ, 31B — 19,7 ГБ. Первой хватит карты 12 ГБ, двум другим нужна 24 ГБ.
- Что значит A4B в Gemma 4 26B-A4B?
- Это 4 млрд активных параметров. Модель устроена как смесь экспертов: всего 26 млрд параметров, но на каждый токен работают около 4 млрд, поэтому она отвечает быстрее плотной модели того же размера.
- Пойдёт ли Gemma 4 на RTX 3060 12 ГБ?
- Gemma 4 12B в Q4_K_M — да: 8,3 ГБ при контексте 8K и 10,2 ГБ даже при 128K. Версии 26B-A4B и 31B на 12 ГБ не помещаются.
- Gemma 4 понимает картинки?
- Да, все три версии — 12B, 26B-A4B и 31B — принимают изображения вместе с текстом. Картинки занимают часть контекста, поэтому много крупных снимков в одном диалоге быстро его заполняют.
- Где запустить Gemma 4 без своей видеокарты?
- Арендуйте сервер с видеокартой на 24 ГБ и шаблоном «Gemma 4 26B»: через 2–5 минут откроется чат и API. Оплата поминутная, остановили сервер — платите только за диск.


