8 мин чтения ·
Видеокарта для нейросетей: как выбрать по задаче и видеопамяти
Для чата с моделью до 14B хватит 12 ГБ, для FLUX и моделей 27–32B — 24 ГБ, для 70B — 48 ГБ. Таблица задач, видеокарты по объёму памяти и цены аренды.
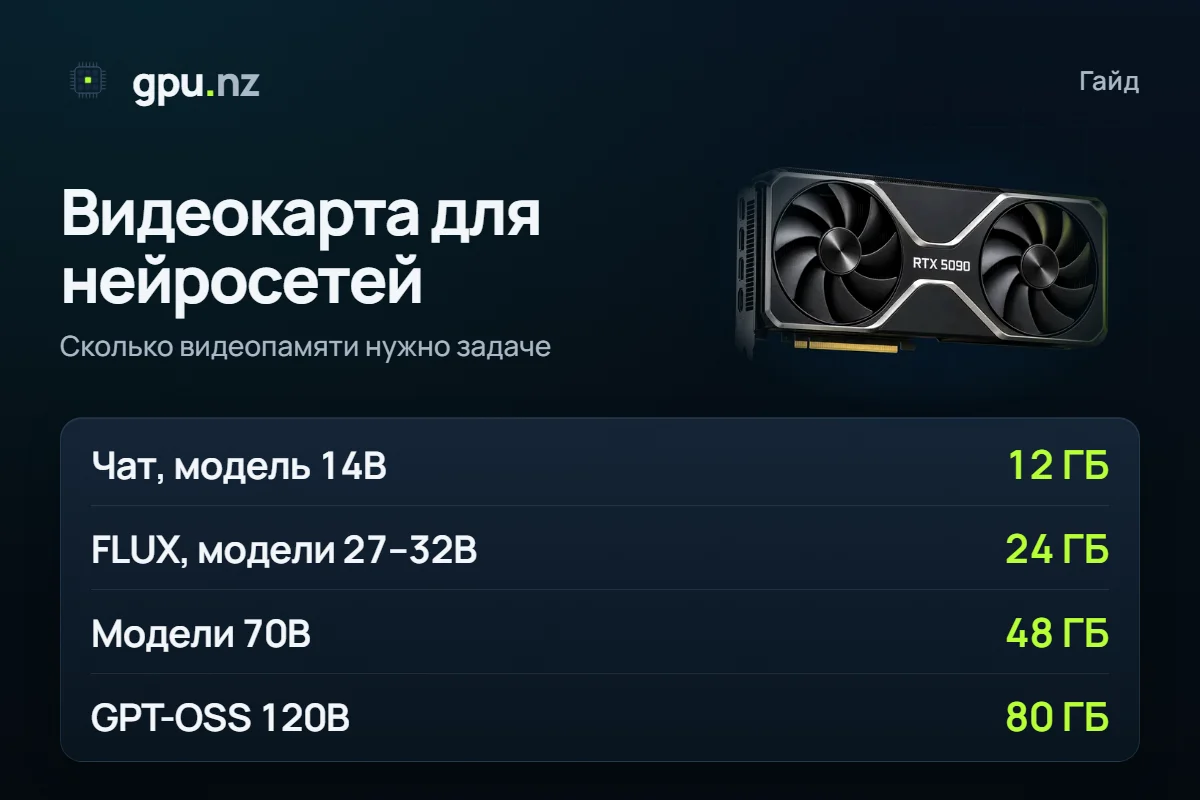
Видеокарту для нейросетей выбирают по объёму видеопамяти: модель должна целиком поместиться в память карты. Чат с моделью на 14 млрд параметров работает на 12 ГБ, модели на 27–32 млрд, FLUX и видео Wan 2.2 — на 24 ГБ, Llama 3.3 70B — на 48 ГБ, GPT-OSS 120B — на 80 ГБ. Ниже — таблица «задача → память», какие карты к какому объёму относятся и сколько они стоят в аренде прямо сейчас.
- чат и код с моделью до 14 млрд параметров
- 12 ГБ
- чат и код с моделью до 14 млрд параметров
- модели 27–32 млрд, FLUX, видео Wan 2.2
- 24 ГБ
- модели 27–32 млрд, FLUX, видео Wan 2.2
- модели на 70 млрд параметров
- 48 ГБ
- модели на 70 млрд параметров
- GPT-OSS 120B на одной карте
- 80 ГБ
- GPT-OSS 120B на одной карте
Почему главное — объём видеопамяти
Нейросеть работает быстро, только когда её веса лежат в видеопамяти. Если памяти не хватает, часть модели уходит в оперативную память компьютера, и генерация замедляется в разы. Поэтому сначала смотрите на гигабайты, а уже потом на поколение и скорость карты.
Скорость тоже важна, но она решает, как быстро модель отвечает. Память решает, запустится ли модель вообще. RTX 3090 и RTX 4090 — карты разных поколений, но у обеих 24 ГБ, и на обеих работают одни и те же модели.
Сколько памяти нужно, зависит от трёх вещей: размера модели (число параметров), квантизации — сжатия весов (Q4 хранит около 4,8 бита на параметр вместо 16) — и длины контекста, то есть сколько текста модель держит в голове. Подробно о расчёте — в гайде «Сколько видеопамяти нужно для LLM».
Сколько видеопамяти нужно под задачу
Для чата и кода хватает 12 ГБ, для картинок FLUX — 16 ГБ, для сильных моделей и видео — 24 ГБ. Цифры посчитаны по реальным файлам моделей.
- Qwen3 8BПростой чат6,8 ГБ
- Qwen3 14BЧат и код10,7 ГБ
- FLUX.1 [dev]Картинки FLUX13,3 ГБ
- Qwen3.8 27BСильная модель для текста и кода17,2 ГБ
- Wan 2.2 A14BВидео 720p21 ГБ
- Llama 3.3 70BМодель 70B43,1 ГБ
- GPT-OSS 120BБольшая модель на одной карте60,5 ГБ
| Задача | Типичная модель | Видеопамять | Минимальная карта |
|---|---|---|---|
| Простой чат | Qwen3 8B · Q4_K_M | 6,8 ГБ | 8 ГБ |
| Картинки SDXL | Stable Diffusion XL | 6,8 ГБ | 8 ГБ |
| Чат и код | Qwen3 14B · Q4_K_M | 10,7 ГБ | 12 ГБ |
| Быстрые картинки | FLUX.2 [klein] 9B · FP8 | 10,6 ГБ | 12 ГБ |
| Ассистент на одной карте | GPT-OSS 20B · MXFP4 | 12,6 ГБ | 16 ГБ |
| Картинки FLUX | FLUX.1 [dev] · FP8 | 13,3 ГБ | 16 ГБ |
| Сильная модель для текста и кода | Qwen3.8 27B · Q4_K_M | 17,2 ГБ | 24 ГБ |
| Видео 720p | Wan 2.2 A14B · FP8 | 21,0 ГБ | 24 ГБ |
| Редактирование картинок | Qwen-Image-Edit · FP8 | 21,6 ГБ | 24 ГБ |
| Видео LTX | LTX-2.5 22B · FP8 | 27,0 ГБ | 32 ГБ |
| FLUX без сжатия | FLUX.1 [dev] · BF16 | 24,3 ГБ | 32 ГБ |
| FLUX.2 | FLUX.2 [dev] · FP8 | 36,1 ГБ | 48 ГБ |
| Модель 70B | Llama 3.3 70B · Q4_K_M | 43,1 ГБ | 48 ГБ |
| Большая модель на одной карте | GPT-OSS 120B · MXFP4 | 60,5 ГБ | 80 ГБ |
Какие видеокарты подходят для нейросетей
Главный рабочий объём — 24 ГБ: на нём запускается большинство открытых моделей для текста, кода, картинок и видео. Ниже — ступени памяти, карты с таким объёмом и задачи, для которых эта ступень минимальна.
| Память | Видеокарты | Что запустится (минимальная карта для этого) |
|---|---|---|
| 8 ГБ | RTX 3060 Ti, RTX 4060 | Qwen3 8B, Stable Diffusion XL |
| 12 ГБ | RTX 3060 12 ГБ | Qwen3 14B, FLUX.2 [klein] 9B |
| 16 ГБ | RTX 4060 Ti 16 ГБ, RTX 4080 | GPT-OSS 20B, FLUX.1 [dev] FP8 |
| 24 ГБ | RTX 3090, RTX 4090, RTX A5000 | Qwen3.8 27B, Wan 2.2 A14B, Qwen-Image-Edit |
| 32 ГБ | RTX 5090 | LTX-2.5 22B, FLUX.1 [dev] BF16 |
| 48 ГБ | RTX A6000, L40S | FLUX.2 [dev], Llama 3.3 70B |
| 80 ГБ | A100 80 ГБ, H100 | GPT-OSS 120B |
Посчитайте память для своей модели
Выберите модель, квантизацию и длину контекста: калькулятор покажет, сколько памяти нужно и какие карты из каталога подходят дешевле всего.
Игровая или серверная видеокарта
Для запуска готовых моделей до 32 млрд параметров достаточно игровых карт на 24–32 ГБ: RTX 3090, RTX 4090, RTX 5090. Серверные A100, H100 и H200 нужны, когда модель не помещается в 32 ГБ, когда нужна одна карта на 80 ГБ и больше или когда вы дообучаете модель.
- Дообучение LoRA модели на 7–8 млрд параметров — ориентир 24 ГБ, QLoRA — 16 ГБ. Подробнее — в гайде о выборе карты для LoRA.
- Полное дообучение модели на 7 млрд требует около 112 ГБ: это две карты по 80 ГБ.
- API для многих пользователей на vLLM: каждый одновременный запрос держит свой кэш контекста, поэтому памяти нужно с запасом.
Купить видеокарту или арендовать
Своя карта выгодна, если она загружена почти всё время. Если нейросети нужны на несколько часов в неделю или вы ещё выбираете модель, аренда обходится дешевле: платите только за минуты работы и в любой момент переходите на карту побольше. Разбор с расчётом окупаемости — в статье «Купить H100 или арендовать».
Как запустить нейросеть на арендованной видеокарте
Посчитайте память
Найдите свою модель в калькуляторе видеопамяти или в таблице выше. Возьмите карту с запасом: если загрузка выше 92%, длинный разговор может не поместиться.
Выберите видеокарту
В каталоге отфильтруйте карты по памяти. Цена за час видна сразу, оплата поминутная.
Выберите шаблон
Для чата — Open WebUI + Ollama или готовые чаты с моделями, для API на несколько человек — vLLM, для картинок — шаблоны с ComfyUI и Forge. Все шаблоны — на странице шаблонов.
Работайте и останавливайте сервер
Сервер стартует за 2–5 минут. Закончили — остановите: GPU перестаёт тарифицироваться, платите только за диск.
Что может пойти не так
- Карта впритык. Модель запустится, но длинный контекст или крупная картинка уже не поместятся. Берите карту, где модель занимает не больше 90% памяти.
- Не та квантизация. Одна и та же модель в BF16 весит в 3–4 раза больше, чем в Q4_K_M. Проверяйте, какой файл вы скачиваете.
- AMD и Mac. Большинство инструментов для нейросетей — PyTorch, ComfyUI, vLLM — рассчитаны в первую очередь на видеокарты NVIDIA с CUDA. На других платформах часть моделей запускается сложнее или медленнее.
Как мы считали
Языковые модели: веса — реальные размеры файлов GGUF и родных форматов с Hugging Face, кэш контекста — по архитектуре каждой модели, плюс около 0,75 ГБ служебной памяти CUDA; контекст 8K, один запрос. Картинки и видео — модель, VAE и рабочая память генерации в ComfyUI. Карта подходит, если модель занимает не больше 97,5% её памяти. 1 ГБ — 1024³ байт. Данные на 2026-10-19; таблица по 35 языковым моделям — в статье «Сколько видеопамяти нужно открытым LLM».
Вопросы и ответы
- Какая видеокарта нужна для нейросетей?
- Смотрите на объём видеопамяти. Для чата с моделью до 14 млрд параметров хватит 12 ГБ, для большинства моделей на 27–32 млрд, FLUX и видео — 24 ГБ, для моделей на 70 млрд — 48 ГБ.
- Хватит ли 8 ГБ видеопамяти для нейросети?
- Для небольших задач — да: модель на 8 млрд параметров в Q4_K_M и картинки SDXL помещаются в 8 ГБ. Для FLUX нужно 16 ГБ, для моделей на 27–32 млрд — 24 ГБ.
- RTX 3090 или RTX 4090 для нейросетей?
- У обеих 24 ГБ, поэтому на них запускаются одни и те же модели. RTX 4090 новее и считает быстрее, RTX 3090 дешевле. Если важен объём, а не скорость, 3090 решает те же задачи.
- Можно ли запускать нейросети на видеокарте AMD?
- Можно, но сложнее: PyTorch, ComfyUI, vLLM и большинство готовых сборок рассчитаны в первую очередь на NVIDIA с CUDA. Если нужна простая установка без сюрпризов, берите NVIDIA.
- Что делать, если своей видеокарты нет или она слабая?
- Арендовать сервер с нужной картой на время работы. Сервер с готовым окружением запускается за 2–5 минут, оплата поминутная, а остановленный сервер не тратит деньги на GPU.


