9 мин чтения ·
RTX PRO 6000 Blackwell 96 ГБ для нейросетей: что помещается
29 из 35 LLM помещаются на RTX PRO 6000 с 96 ГБ, 23 — без сжатия. Таблица по моделям при контексте 8K и 32K, сравнение с 5090 и картами на 48 и 80 ГБ.
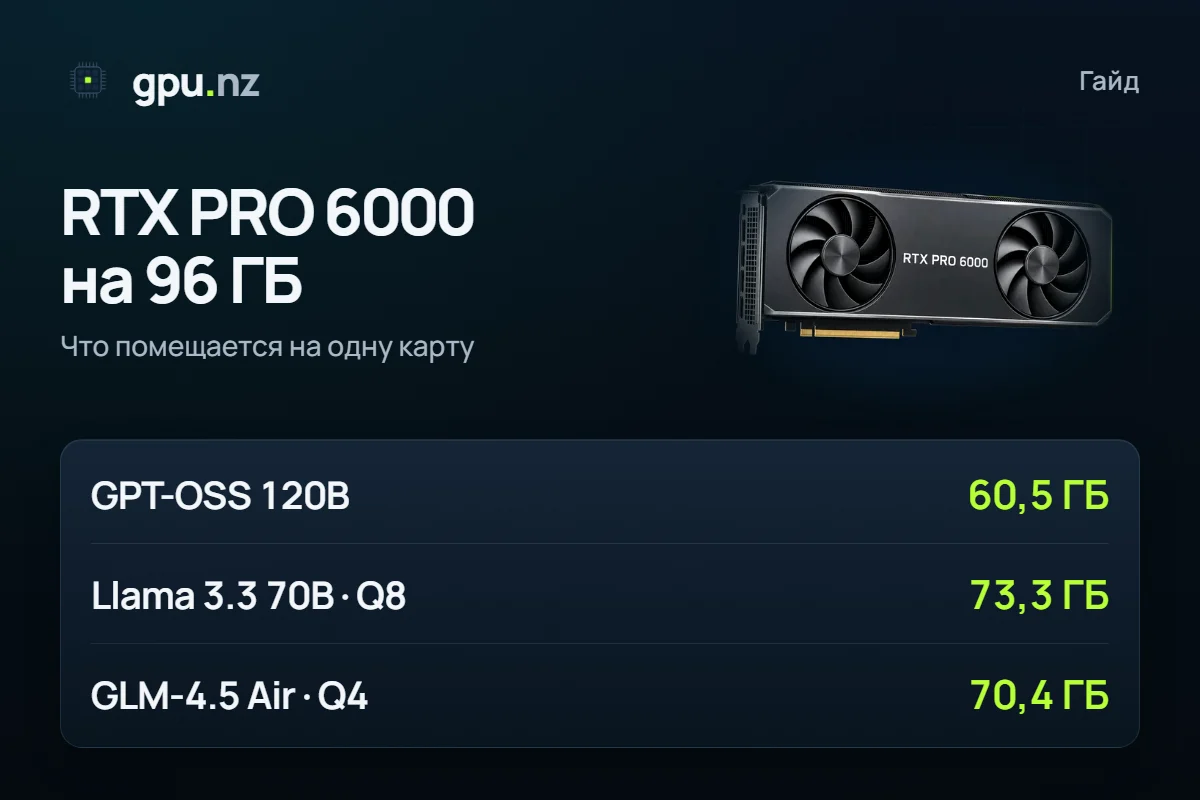
Одна RTX PRO 6000 Blackwell с 96 ГБ видеопамяти вмещает 29 из 35 открытых LLM нашего калькулятора при контексте 8K, 23 из них — без сжатия. Llama 3.3 70B идёт в Q8_0 с контекстом 32K (80,8 ГБ), GPT-OSS 120B занимает 60,5 ГБ. Ниже таблица по всем моделям, сравнение с картами на 32, 48 и 80 ГБ, картинки с видео и запуск на арендованной карте.
- LLM помещаются в 96 ГБ в какой-нибудь точности, контекст 8K
- 29 из 35
- LLM помещаются в 96 ГБ в какой-нибудь точности, контекст 8K
- из них в исходной точности: BF16 или родной формат релиза
- 23 из 35
- из них в исходной точности: BF16 или родной формат релиза
- GPT-OSS 120B в MXFP4, контекст 8K
- 60,5 ГБ
- GPT-OSS 120B в MXFP4, контекст 8K
- Llama 3.3 70B в Q8_0, контекст 32K
- 80,8 ГБ
- Llama 3.3 70B в Q8_0, контекст 32K
Что за карта: 96 ГБ GDDR7 в трёх исполнениях
RTX PRO 6000 Blackwell — профессиональная видеокарта NVIDIA с 96 ГБ памяти GDDR7 с коррекцией ошибок (ECC). Исполнений три: Workstation Edition для рабочих станций, Max-Q Workstation Edition на 300 Вт и Server Edition для серверов. Память у всех одинаковая, различаются мощность, охлаждение и пропускная способность.
| Исполнение | Память | Пропускная способность | Мощность | Корпус |
|---|---|---|---|---|
| Workstation Edition | 96 ГБ GDDR7 с ECC | 1792 ГБ/с | до 600 Вт | два слота |
| Max-Q Workstation Edition | 96 ГБ GDDR7 с ECC | 1792 ГБ/с | 300 Вт | два слота, активное охлаждение |
| Server Edition | 96 ГБ GDDR7 с ECC | 1597 ГБ/с | до 600 Вт, настраивается | воздух: два слота; жидкость: один слот |
В каталоге gpu.nz они называются RTX PRO 6000, RTX PRO 6000 Max-Q и RTX PRO 6000 Server. Основная карта с живой ценой — на странице RTX PRO 6000 96 ГБ; здесь разбираем, что на ней запускается.
Какие LLM помещаются в 96 ГБ?
29 из 35: столько моделей при контексте 8K укладываются в 93,6 ГБ, которые программа может занять на карте на 96 ГБ. Остальные примерно 2,5% забирают драйвер и CUDA. Для каждой модели мы искали самую высокую точность из ряда BF16, FP8, Q8_0, Q6_K, Q5_K_M, Q4_K_M, Q3_K_M, Q2_K, при которой она помещается.
Точность — это способ хранить веса: чем выше, тем ближе модель к исходной. Q8_0 и FP8 обычно мало отличаются от оригинала, Q4_K_M — привычный компромисс, у Q2_K качество ответов заметно ниже.
- 32 ГБ · RTX 509012 из 35
- 48 ГБ · RTX A6000, L40S13 из 35
- 80 ГБ · A100, H10023 из 35
- 96 ГБ · RTX PRO 600023 из 35
Разница между 48 и 80 ГБ большая, между 80 и 96 ГБ по этому показателю нулевая: в исходной точности помещается одно и то же число моделей — 23. Лишние 16 ГБ нужны не для этого, ниже разберём, для чего.
Полная таблица, от самых больших моделей к самым маленьким. В ячейке — точность и память всей конфигурации: веса, кэш контекста и служебные буферы. Пометка «впритык» значит, что занято больше 92% памяти.
| Модель | Максимальная точность, контекст 8K | Максимальная точность, контекст 32K |
|---|---|---|
| Kimi K2 1T | не помещается | не помещается |
| DeepSeek V3.2 | не помещается | не помещается |
| DeepSeek R1 671B | не помещается | не помещается |
| Qwen3 Coder 480B-A35B | не помещается | не помещается |
| GLM-5.3 Flash | не помещается | не помещается |
| Hunyuan Hy3 | не помещается | не помещается |
| DeepSeek V4 Flash | UD-Q2_K_XL, 91,3 ГБ, впритык | UD-Q2_K_XL, 91,6 ГБ, впритык |
| Qwen3 235B-A22B | Q2_K, 82,3 ГБ | Q2_K, 86,7 ГБ, впритык |
| GPT-OSS 120B | MXFP4, 60,5 ГБ | MXFP4, 61,3 ГБ |
| GLM-4.5 Air | Q5_K_M, 80,3 ГБ | Q5_K_M, 84,6 ГБ |
| Qwen3 Next 80B-A3B | FP8, 77,7 ГБ | FP8, 78,3 ГБ |
| Llama 3.3 70B | Q8_0, 73,3 ГБ | Q8_0, 80,8 ГБ |
| Hermes 4.3 36B | Q8_0, 38,8 ГБ | Q8_0, 44,8 ГБ |
| Qwen3 32B | BF16, 64,1 ГБ | BF16, 70,1 ГБ |
| DeepSeek R1 Distill Qwen 32B | BF16, 64,1 ГБ | BF16, 70,1 ГБ |
| Gemma 4 31B | BF16, 59,9 ГБ | BF16, 61,7 ГБ |
| GLM-4.7 Flash | BF16, 57,3 ГБ | BF16, 58,5 ГБ |
| Qwen3 30B-A3B | BF16, 58,7 ГБ | BF16, 60,9 ГБ |
| Qwen3 Coder 30B-A3B | BF16, 58,7 ГБ | BF16, 60,9 ГБ |
| Qwen3.8 27B | BF16, 52,8 ГБ | BF16, 54,3 ГБ |
| Gemma 3 27B | BF16, 52,6 ГБ | BF16, 54,5 ГБ |
| Gemma 4 26B-A4B | BF16, 48,6 ГБ | BF16, 49,1 ГБ |
| Mistral Small 3.2 24B | BF16, 46,2 ГБ | BF16, 49,9 ГБ |
| Devstral Small 2 24B | BF16, 46,2 ГБ | BF16, 49,9 ГБ |
| GPT-OSS 20B | MXFP4, 12,6 ГБ | MXFP4, 13,2 ГБ |
| Qwen3 14B | BF16, 29,8 ГБ | BF16, 33,6 ГБ |
| Phi-4 14B | BF16, 29,8 ГБ | контекст модели — до 16K |
| Ministral 3 14B | BF16, 27,4 ГБ | BF16, 31,2 ГБ |
| Mistral Nemo 12B | BF16, 25,1 ГБ | BF16, 28,8 ГБ |
| Gemma 4 12B | BF16, 23,9 ГБ | BF16, 24,3 ГБ |
| Qwen3.5 9B | BF16, 18,2 ГБ | BF16, 19,0 ГБ |
| Qwen3 8B | BF16, 17,4 ГБ | BF16, 20,8 ГБ |
| DeepSeek R1 0528 Qwen3 8B | BF16, 17,4 ГБ | BF16, 20,8 ГБ |
| Llama 3.1 8B | BF16, 17,0 ГБ | BF16, 20,0 ГБ |
| Qwen3.5 4B | BF16, 9,4 ГБ | BF16, 10,1 ГБ |
Что дают 96 ГБ по сравнению с 32, 48 и 80 ГБ?
В 3 раза больше памяти, чем у карты на 32 ГБ, в 2 раза больше, чем на 48 ГБ, и на 16 ГБ больше, чем у A100 и H100. Что это значит для крупных моделей, видно в таблице: самая высокая точность при контексте 8K.
| Модель | 32 ГБ RTX 5090 | 48 ГБ RTX A6000 | 80 ГБ A100, H100 | 96 ГБ RTX PRO 6000 |
|---|---|---|---|---|
| Qwen3 32B | Q6_K 28,1 ГБ | FP8 35,0 ГБ | BF16 64,1 ГБ | BF16 64,1 ГБ |
| Llama 3.3 70B | Q2_K 28,1 ГБ | Q4_K_M 43,1 ГБ | Q8_0 73,3 ГБ | Q8_0 73,3 ГБ |
| GPT-OSS 120B | — | — | MXFP4 60,5 ГБ | MXFP4 60,5 ГБ |
| GLM-4.5 Air | — | Q2_K 44,7 ГБ | Q4_K_M 70,4 ГБ | Q5_K_M 80,3 ГБ |
| Qwen3 Next 80B-A3B | Q2_K 28,5 ГБ | Q4_K_M 46,5 ГБ | FP8 77,7 ГБ | FP8 77,7 ГБ |
| Qwen3 235B-A22B | — | — | — | Q2_K 82,3 ГБ |
- Против 32 ГБ (RTX 5090). Llama 3.3 70B на 32 ГБ помещается только в Q2_K, на 96 ГБ — в Q8_0. GPT-OSS 120B на 32 ГБ не помещается ни в каком виде. У RTX 5090 и RTX PRO 6000 Workstation одинаковая пропускная способность памяти, 1792 ГБ/с (данные NVIDIA), поэтому ускорения от лишних гигабайт ждать не стоит: они меняют то, что вообще можно запустить.
- Против 48 ГБ (RTX A6000, L40S). Для Llama 3.3 70B на 48 ГБ потолок — Q4_K_M, а с контекстом 32K — Q3_K_M. GPT-OSS 120B и GLM-4.5 Air в хорошей точности на 48 ГБ не помещаются.
- Против 80 ГБ (A100, H100). Выигрыш скромнее: всё, что идёт на 80 ГБ в исходной точности, идёт и на 96. Зато GLM-4.5 Air помещается в Q5_K_M вместо Q4_K_M, Llama 3.3 70B с контекстом 32K — в Q8_0 вместо Q6_K, а Qwen3 235B-A22B запускается на одной карте, хотя и в Q2_K.
- Qwen3 Next 80B-A3B · FP8 · 32K78,3 ГБ
- GLM-4.5 Air · Q5_K_M · 8K80,3 ГБ
- Llama 3.3 70B · Q4_K_M · 128K80,6 ГБ
- Llama 3.3 70B · Q8_0 · 32K80,8 ГБ
- Qwen3 235B-A22B · Q2_K · 8K82,3 ГБ
Отдельная причина — длинный контекст. Кэш Llama 3.3 70B занимает 10,0 ГБ на каждые 32K токенов, поэтому в Q4_K_M с контекстом 128K модель требует 80,6 ГБ. На карте 80 ГБ она не помещается, на 96 ГБ — да.
Не забывайте про скорость. У A100 SXM пропускная способность памяти 2039 ГБ/с, у H100 SXM — 3,35 ТБ/с (данные NVIDIA), у RTX PRO 6000 — 1792 ГБ/с. Для одного запроса скорость генерации обычно упирается в пропускную способность, а не в объём, поэтому модель, которая помещается в 80 ГБ, может отвечать на H100 быстрее. Замеров на этих картах мы не делали.
Сколько запросов выдержит карта одновременно?
Столько, сколько кэшей контекста поместится рядом с весами. Расчёт для запросов по 32K токенов при 90% памяти карты (столько по умолчанию занимает vLLM) показывает большой разброс:
- GPT-OSS 120B — до 23: кэш этой модели растёт медленно.
- Qwen3 Next 80B-A3B в Q4_K_M — до 48: часть её слоёв хранит фиксированное состояние вместо растущего кэша.
- Llama 3.3 70B в Q4_K_M — до 4: плотная модель, каждый запрос держит 10,0 ГБ.
Это верхняя граница: учтены веса, кэш и служебная память, но не пиковые нагрузки. Для сервиса оставьте запас.
Какие картинки и видео запускаются на 96 ГБ?
Все 14 моделей картинок и видео нашего калькулятора. 13 из них держатся в памяти целиком уже в BF16, без сжатия. На 32 ГБ целиком в BF16 помещаются только 6.
Первое число в таблице — минимум: ComfyUI выгружает текстовый энкодер перед генерацией, так он поступает, когда памяти мало. Второе — когда всё остаётся в памяти и повторные запуски не ждут загрузки. Для видео взято самое большое разрешение с данными, обычно 720p.
| Модель | BF16: минимум / всё в памяти | FP8: минимум / всё в памяти |
|---|---|---|
| FLUX.1 dev / schnell / Kontext | 24,3 / 33,4 ГБ | 13,3 / 18,0 ГБ |
| FLUX.2 dev | 63,1 / 96,3 ГБ | 36,1 / 52,9 ГБ |
| FLUX.2 klein 9B | 19,1 / 34,3 ГБ | 10,6 / 18,3 ГБ |
| FLUX.2 klein 4B | 8,9 / 16,4 ГБ | 5,3 / 9,1 ГБ |
| Qwen-Image / Qwen-Image-Edit | 40,6 / 56,1 ГБ | 21,6 / 30,3 ГБ |
| Stable Diffusion 3.5 Large | 17,2 / 27,6 ГБ | 9,6 / 15,7 ГБ |
| Stable Diffusion XL | 6,8 / 8,3 ГБ | версии FP8 нет |
| Stable Diffusion 1.5 | 2,9 / 3,1 ГБ | версии FP8 нет |
| Wan 2.2 A14B (T2V / I2V) | 34,3 / 71,5 ГБ | 21,0 / 40,6 ГБ |
| Wan 2.2 TI2V 5B | 16,2 / 26,8 ГБ | 11,6 / 17,8 ГБ |
| Wan 2.1 14B | 34,3 / 44,9 ГБ | 21,0 / 27,3 ГБ |
| Wan 2.1 1.3B | 11,1 / 15,8 ГБ | версии FP8 нет |
| HunyuanVideo 1.5 | 26,2 / 41,7 ГБ | 18,5 / 27,2 ГБ |
| LTX-2.5 22B | 46,1 / 68,3 ГБ | 27,0 / 38,1 ГБ |
Исключение одно: FLUX.2 [dev] в BF16 целиком в 96 ГБ не помещается (96,3 ГБ), но с выгрузкой энкодера идёт на 63,1 ГБ. Wan 2.2 A14B в BF16 с обоими экспертами в памяти занимает 71,5 ГБ: для этого нужна карта 80 ГБ. Подробнее про модели — в гайдах FLUX и видео на своём GPU.
Что не поместится даже на 96 ГБ?
Крупные MoE-модели: Qwen3 235B-A22B и DeepSeek V4 Flash формально входят только в Q2_K (V4 Flash занимает 98% памяти), а остальные не входят вовсе. Таблица показывает, сколько карт по 96 ГБ понадобится для файла по умолчанию, если делить модель между картами (tensor parallel).
| Модель | Файл по умолчанию и память (8K) | Нужно карт по 96 ГБ |
|---|---|---|
| Qwen3 235B-A22B | Q4_K_M, 134,9 ГБ | 2 × 96 ГБ |
| DeepSeek V4 Flash | Q4_K_M, 145,5 ГБ | 2 × 96 ГБ |
| GLM-5.3 Flash | Q4_K_M, 187,3 ГБ | 4 × 96 ГБ |
| Qwen3 Coder 480B-A35B | Q4_K_M, 273,1 ГБ | 4 × 96 ГБ |
| Hunyuan Hy3 | FP8, 282,8 ГБ | 4 × 96 ГБ |
| DeepSeek R1 671B | Q4_K_M, 378,7 ГБ | 8 × 96 ГБ |
| DeepSeek V3.2 | Q4_K_M, 379,1 ГБ | 8 × 96 ГБ |
| Kimi K2 1T | Q4_K_M, 580,2 ГБ | 8 × 96 ГБ |
Серверы с 2, 4 или 8 такими картами бывают не всегда: наличие смотрите в каталоге. Для DeepSeek V4 Flash есть отдельный разбор.
Посчитайте свою модель
Выберите модель, квантизацию и длину контекста: калькулятор покажет память и карты каталога, на которых модель запустится дешевле всего.
Покупать RTX PRO 6000 или арендовать?
Если ваша модель помещается в 32 или 48 ГБ, платить за 96 ГБ незачем. Покупка имеет смысл при загрузке почти каждый день, а считать её стоит по формуле из статьи «Купить H100 или арендовать»: она подходит и для этой карты.
К цене карты добавьте всё вокруг неё. Workstation Edition рассчитана на 600 Вт, то есть до 14,4 кВт·ч в сутки под полной нагрузкой, плюс блок питания, охлаждение и место. Прежде чем покупать, арендуйте карту на час и проверьте на своей модели, помещается ли она и устраивает ли скорость.
Как запустить модель на арендованной RTX PRO 6000
Возьмём Llama 3.3 70B в Q8_0 через шаблон Ollama. GPT-OSS 120B проще: у неё есть готовый шаблон.
Выберите RTX PRO 6000 в каталоге
Откройте каталог, найдите RTX PRO 6000 с 96 ГБ (подойдёт любое исполнение) и нажмите «Арендовать».
Выберите шаблон
Для GPT-OSS 120B возьмите шаблон GPT-OSS 120B: он скачает модель и откроет чат и API. Для остальных моделей из таблицы подойдёт Open WebUI + Ollama.
Укажите модель и диск
В поле «Модель» впишите тег из библиотеки Ollama (файл около 75 ГБ) или выполните команду по SSH. Диск возьмите от 100 ГБ.
ollama pull llama3.3:70b-instruct-q8_0Подождите, пока скачается модель
Сервер стартует за 2–5 минут, затем идёт загрузка файла: для 65–75 ГБ это обычно 10–30 минут, иногда дольше. Когда модель будет готова, откройте чат кнопкой Open WebUI.
Подключите API, если нужно
Адрес — из кнопки «Ollama API», токен — со страницы сервера, модель — тот же тег.
curl "https://<id>-11434.run.gpu.nz/v1/chat/completions" \ -H "Authorization: Bearer <токен>" \ -H "Content-Type: application/json" \ -d '{"model": "llama3.3:70b-instruct-q8_0", "messages": [{"role": "user", "content": "Привет"}]}'Остановите сервер, когда закончили
Оплата поминутная: остановленный сервер не тратит деньги на GPU, платите только за диск.
Для API с несколькими пользователями возьмите шаблон vLLM и перезапустите сервер с FP8-версией Qwen3 Next 80B-A3B: файл около 82 ГБ, с контекстом 32K модель занимает 78,3 ГБ. Диск возьмите от 150 ГБ. Контекст ограничен параметром --max-model-len, как советует карточка модели на Hugging Face; токен передавайте в --api-key явно, иначе API останется открытым.
pkill -f api_server
nohup vllm serve Qwen/Qwen3-Next-80B-A3B-Instruct-FP8 --host 0.0.0.0 --port 8000 \
  --api-key <токен аренды> --max-model-len 32768 > /var/log/vllm.log 2>&1 &
tail -f /var/log/vllm.log
Что может пойти не так
- «Помещается» не значит «быстро». Мы считали память, а не скорость. Мощность (300 и 600 Вт) и пропускная способность у исполнений разные, а замеров скорости на этих картах у нас нет.
- Карта впритык. Если конфигурация занимает больше 92% памяти (в таблице это помечено), модель запустится, но длинный разговор или второй запрос могут не поместиться. DeepSeek V4 Flash в Q2_K занимает 98% памяти, а у двухбитной квантизации качество заметно ниже.
- Параллельные запросы умножают кэш. Цифры в таблицах — для одного запроса. Каждый одновременный запрос держит свой кэш контекста, поэтому сервис на несколько человек требует запаса.
- Blackwell требует свежего ПО. NVIDIA называет CUDA 12.8 первой версией с поддержкой этой архитектуры. Если ставите PyTorch или свой образ сами, берите сборки под CUDA 12.8 и новее: на более старых возможны сбои и ошибки вроде «no kernel image is available for execution on the device».
Как мы считали
Веса — реальные размеры файлов: GGUF из репозиториев unsloth на Hugging Face, FP8 и BF16 — из репозиториев авторов моделей. Кэш контекста посчитан по config.json каждой модели. Служебная память — около 0,75 ГБ плюс буфер логитов. 1 ГБ здесь — 1024³ байт, как у видеокарт. Модель «помещается», если вся конфигурация занимает не больше 97,5% памяти карты. «Исходная точность» — BF16 или формат, в котором модель выпустили (MXFP4, FP8). Данные на 2026-10-19.
Память, пропускная способность и мощность карт — со страниц продуктов NVIDIA на nvidia.com (RTX PRO 6000 Workstation, Max-Q и Server Edition, RTX 5090, A100, H100), прочитаны 20.10.2026. Всё это расчёт по памяти: конфигурации из статьи на RTX PRO 6000 мы не прогоняли и скорость не измеряли. Методика — в калькуляторе, таблица по 35 моделям — в статье «Сколько видеопамяти нужно открытым LLM».
Вопросы и ответы
- Что можно запустить на RTX PRO 6000 с 96 ГБ?
- Из 35 LLM нашего калькулятора на одну карту помещаются 29 при контексте 8K, 23 из них без сжатия. Среди них GPT-OSS 120B (60,5 ГБ), Llama 3.3 70B в Q8_0 (73,3 ГБ) и Qwen3 32B в BF16 (64,1 ГБ). Из картинок и видео помещаются все модели калькулятора.
- Сколько видеопамяти у RTX PRO 6000 Blackwell?
- 96 ГБ памяти GDDR7 с коррекцией ошибок (ECC) у всех трёх исполнений: Workstation Edition, Max-Q Workstation Edition и Server Edition. Так указано на страницах NVIDIA. Различаются мощность (300 Вт у Max-Q, до 600 Вт у остальных) и пропускная способность памяти.
- RTX PRO 6000 или RTX 5090 для нейросетей: что выбрать?
- Если модель помещается в 32 ГБ, хватит RTX 5090. Если нет, нужна RTX PRO 6000: Llama 3.3 70B на 32 ГБ входит только в Q2_K, на 96 ГБ — в Q8_0, а GPT-OSS 120B на 32 ГБ не входит совсем. У RTX 5090 и RTX PRO 6000 Workstation пропускная способность памяти по данным NVIDIA одинакова, 1792 ГБ/с.
- Помещается ли Llama 3.3 70B на RTX PRO 6000?
- Да. В Q8_0 с контекстом 8K она занимает 73,3 ГБ, с контекстом 32K — 80,8 ГБ. В Q4_K_M помещается даже контекст 128K: 80,6 ГБ.
- Хватит ли 96 ГБ для GPT-OSS 120B?
- Да, с большим запасом: 60,5 ГБ с контекстом 8K и 61,3 ГБ с контекстом 32K. Остаток памяти по расчёту вмещает до 23 одновременных запросов по 32K токенов.
- Где арендовать RTX PRO 6000 без покупки?
- В каталоге gpu.nz: карта доступна в исполнениях RTX PRO 6000, Max-Q и Server, оплата поминутная. Цена меняется, актуальная указана на странице карты и в карточках каталога.


