11 мин чтения ·
GGUF, Q4_K_M, FP8, MXFP4: что значат и сколько памяти экономят
Qwen3.8 27B: 50,9 ГБ в BF16 и 15,3 ГБ в Q4_K_M. Что значат GGUF, Q8_0, FP8 и MXFP4, сколько памяти экономит каждый формат и как скачать нужный файл.
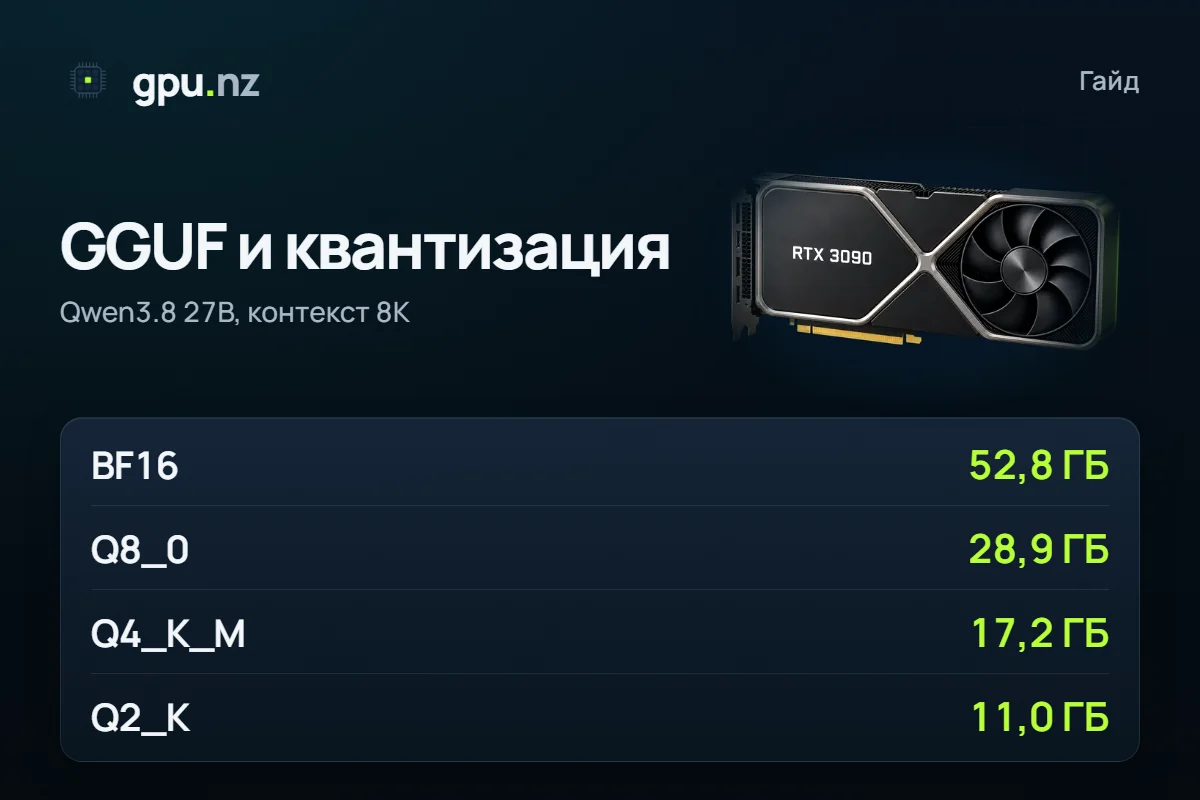
Квантизация хранит веса модели не в 16 битах, а в 8, 6, 4 или 3, и файл уменьшается в 1,9–5,3 раза. Qwen3.8 27B весит 50,9 ГБ в исходном BF16 и 15,3 ГБ в Q4_K_M, поэтому с контекстом 8K ей нужна карта на 24 ГБ вместо 80 ГБ. Ниже — что значат GGUF, Q8_0, Q4_K_M, FP8 и MXFP4, таблица памяти для четырёх моделей, замеры качества и команды, как скачать нужный файл.
- Qwen3.8 27B, веса в исходном BF16
- 50,9 ГБ
- Qwen3.8 27B, веса в исходном BF16
- те же веса в Q4_K_M: в 3,3 раза меньше
- 15,3 ГБ
- те же веса в Q4_K_M: в 3,3 раза меньше
- в среднем на параметр в Q4_K_M: часть тензоров хранится точнее
- 4,84 бита
- в среднем на параметр в Q4_K_M: часть тензоров хранится точнее
- GPT-OSS 120B в родном MXFP4, контекст 8K: одна карта на 80 ГБ
- 60,5 ГБ
- GPT-OSS 120B в родном MXFP4, контекст 8K: одна карта на 80 ГБ
Что такое GGUF: формат файла или квантизация?
GGUF — это формат файла, а не способ сжатия. В одном файле лежат веса модели и метаданные: параметры архитектуры, токенизатор, шаблон чата. По описанию авторов, формат сделан для быстрой загрузки в llama.cpp и программах на его движке — Ollama и LM Studio.
Веса внутри GGUF могут храниться в разной точности — от F32 и BF16 до двух бит и ниже. Какая именно, говорит суффикс в имени файла: Q8_0, Q4_K_M. Для сравнения: safetensors хранит только тензоры, а GGUF — ещё и стандартный набор метаданных.
Поэтому «скачать GGUF» — неполный запрос: в репозитории десятки файлов одной модели, и выбирать нужно квантизацию.
Что значат Q8_0, Q6_K, Q4_K_M и Q2_K в названии файла?
Цифра после Q — примерно число бит на вес, буква K — семейство k-квантов, а M — вариант смеси.
- Q и цифра. Столько бит хранится на один вес; в исходной модели их 16.
- K. Веса делятся на блоки, у каждого свой масштаб; блоки собраны в супер-блоки (так их описывает автор в запросе №1684 к llama.cpp).
- 0 в Q8_0. Схема проще: блок из 32 весов и один множитель. Множитель добавляет полбита, поэтому Q8_0 — это 8,5 бита на вес, а не 8.
- S, M, L. Варианты смеси: в одной модели используются разные типы. В Q4_K_M большинство весов — в 4-битном Q4_K, половина тензоров attention.wv и feed_forward.w2 — в 6-битном Q6_K, выходной слой всегда в 6 битах.
Поэтому Q4_K_M — это 4,84 бита на параметр, а не 4. Он же выбор по умолчанию: Ollama берёт Q4_K_M, если файл есть в репозитории Hugging Face, и llama.cpp с флагом -hf поступает так же.
Все форматы статьи — в таблице. Биты измерены по опубликованным файлам; три последние строки — не k-кванты.
| Формат | Бит на параметр | Меньше, чем BF16 | Что это |
|---|---|---|---|
| BF16 | 16 | 1× | Исходные веса в 16-битных числах. |
| FP8 | 8,4 | 1,9× | 8-битные числа с плавающей запятой. Формат для vLLM. |
| Q8_0 | 8,5 | 1,9× | GGUF, блоки по 32 веса. Почти без потерь. |
| Q6_K | 6,56 | 2,4× | GGUF, k-квант. Почти без потерь. |
| Q5_K_M | 5,68 | 2,8× | GGUF, k-квант. |
| Q4_K_M | 4,84 | 3,3× | GGUF, k-квант. Выбор Ollama и llama.cpp по умолчанию. |
| Q3_K_M | 3,9 | 4,1× | GGUF, k-квант. Потери растут. |
| Q2_K | 3 | 5,3× | GGUF, k-квант. Сильнее всего сжато, потери заметны. |
| MXFP4 | 4,25 | 3,8× | 4-битные числа с общим масштабом на блок; формат GPT-OSS. Биты — для весов экспертов. |
| AWQ, GPTQ | около 4 | — | 4-битные целые числа (INT4) для GPU-движков вроде vLLM. |
| UD-…_XL | — | — | GGUF от Unsloth: тип подобран для каждого слоя. |
Чем FP8, MXFP4, AWQ и GPTQ отличаются от GGUF?
Это другие форматы для других программ. GGUF читают Ollama, LM Studio и llama.cpp. FP8, AWQ и GPTQ рассчитаны на GPU-серверы вроде vLLM, а MXFP4 — родной формат GPT-OSS. Как выбрать программу, разобрано в гайде Ollama, LM Studio, llama.cpp или vLLM.
- FP8 — 8-битные числа с плавающей запятой. По документации vLLM, память под модель сокращается вдвое; у Qwen3.8 27B файл меньше в 1,8 раза (28,7 ГБ против 50,9 ГБ). Считать в FP8 умеют карты с compute capability от 8.9 — Ada, Hopper и Blackwell, например RTX 4090 и H100. На RTX 3090 и A100 вы тоже сэкономите память, но вычисления пойдут в 16 битах.
- MXFP4 — 4-битные числа с общим масштабом на блок. OpenAI выпустила GPT-OSS сразу в нём: по карточке модели, веса экспертов занимают больше 90% параметров и хранятся в 4,25 бита. GPT-OSS 120B весит 59,0 ГБ вместо 217,6 ГБ в BF16 (оценка по числу параметров) и помещается на одну карту 80 ГБ.
- AWQ и GPTQ — 4-битные целые числа (INT4; GPTQ бывает и 8-битным). vLLM загружает готовые чекпойнты с Hugging Face; по его документации, выигрыш — меньше памяти и задержка. GGUF vLLM читает лишь экспериментально, поэтому для него берите FP8 или AWQ.
- UD-…_XL от Unsloth. Динамическая квантизация: тип подбирается для каждого слоя отдельно. Документация не расшифровывает «UD» и «XL». В наших таблицах у Qwen3.8 27B и Gemma 4 31B на месте Q2_K стоит UD-Q2_K_XL: простого файла нет.
Сколько памяти экономит квантизация на реальных моделях?
Q4_K_M уменьшает веса в 3,3 раза, а всю память — чуть меньше: кэш контекста и служебная память не сжимаются. Qwen3.8 27B с контекстом 8K занимает 52,8 ГБ в BF16 и 17,2 ГБ в Q4_K_M — в 3,1 раза меньше. Выбор среди моделей Qwen — в гайде «Какую модель Qwen выбрать».
- BF16исходные веса52,8 ГБ
- FP8vLLM30,6 ГБ
- Q8_0GGUF28,9 ГБ
- Q6_K22,3 ГБ
- Q5_K_M20,3 ГБ
- Q4_K_MOllama по умолчанию17,2 ГБ
- Q2_KUD-Q2_K_XL11 ГБ
Таблица — четыре модели: Qwen3.8 27B, Llama 3.3 70B, Gemma 4 31B и Qwen3 8B. В ячейке, в ГБ: память с контекстом 8K, веса и самая маленькая карта; прочерк — такого файла нет.
| Формат | Qwen3.8 27B | Llama 3.3 70B | Gemma 4 31B | Qwen3 8B |
|---|---|---|---|---|
| BF16 | 52,8 ГБ веса 50,9, карта 80 | 134,9 ГБ веса 131,4, карта 141 | 59,9 ГБ веса 57,2, карта 80 | 17,4 ГБ веса 15,3, карта 24 |
| FP8 | 30,6 ГБ веса 28,7, карта 32 | — | — | 11,0 ГБ веса 8,8, карта 12 |
| Q8_0 | 28,9 ГБ веса 27,1, карта 32 | 73,3 ГБ веса 69,8, карта 80 | 33,1 ГБ веса 30,4, карта 48 | 10,3 ГБ веса 8,1, карта 12 |
| Q6_K | 22,3 ГБ веса 20,5, карта 24 | 57,4 ГБ веса 53,9, карта 80 | 26,1 ГБ веса 23,5, карта 32 | 8,4 ГБ веса 6,3, карта 12 |
| Q5_K_M | 20,3 ГБ веса 18,4, карта 24 | 50,0 ГБ веса 46,5, карта 80 | 22,8 ГБ веса 20,2, карта 24 | 7,6 ГБ веса 5,4, карта 8 |
| Q4_K_M | 17,2 ГБ веса 15,3, карта 24 | 43,1 ГБ веса 39,6, карта 48 | 19,7 ГБ веса 17,1, карта 24 | 6,8 ГБ веса 4,7, карта 8 |
| Q3_K_M | — | 35,4 ГБ веса 31,9, карта 48 | 16,4 ГБ веса 13,7, карта 24 | 6,0 ГБ веса 3,8, карта 8 |
| Q2_K | 11,0 ГБ веса 9,2, карта 12 (UD-Q2_K_XL) | 28,1 ГБ веса 24,6, карта 32 | 13,6 ГБ веса 11,0, карта 16 (UD-Q2_K_XL) | 5,2 ГБ веса 3,1, карта 8 |
Карты бывают только ступенями — 12, 16, 24, 32, 48, 80 ГБ, — поэтому важно не сколько вы сэкономили, а перешагнули ли ступень. У Qwen3.8 27B Q4_K_M, Q5_K_M и Q6_K идут на карту 24 ГБ, Q8_0 и FP8 — на 32 ГБ, BF16 — на 80 ГБ. Llama 3.3 70B в Q4_K_M идёт на 48 ГБ, в Q8_0 — на 80 ГБ. Про Gemma 4 — в гайде об её видеопамяти.
Почему файл не равен «параметры × биты ÷ 8»?
Формула даёт порядок величины, но ошибается на несколько процентов. В таблице — расчёт по битам из таблицы выше и реальный размер файла.
| Модель и формат | По формуле, ГБ | Файл, ГБ | Разница |
|---|---|---|---|
| Qwen3.8 27B, Q4_K_M | 15,7 | 15,3 | −2,0 % |
| Qwen3.8 27B, FP8 | 27,2 | 28,7 | +5,8 % |
| Qwen3.8 27B, Q2_K (UD-Q2_K_XL) | 9,7 | 9,2 | −5,6 % |
| Llama 3.3 70B, Q4_K_M | 39,8 | 39,6 | −0,4 % |
| Gemma 4 31B, Q4_K_M | 17,6 | 17,1 | −3,1 % |
| Qwen3 8B, Q4_K_M | 4,6 | 4,7 | +1,5 % |
| Qwen3 8B, FP8 | 8,0 | 8,8 | +9,7 % |
Расхождение — от −5,6 % до +9,7 %. У Llama 3.3 70B в Q4_K_M оно всего 0,4 %, а файл Qwen3 8B в FP8 больше формулы на 9,7 %. Скорее всего, дело в тензорах, которые остаются точнее: выходной слой k-квантов хранится в 6 битах, а у небольшой модели его доля больше. Файлы Qwen3.8 27B и Gemma 4 31B, наоборот, меньше формулы; причину по таблице не угадать. Поэтому в калькуляторе стоят размеры настоящих файлов, а не расчёт.
Что теряется в качестве при квантизации?
По двум публикациям авторов, Q8_0 и Q6_K почти не отличаются от исходной модели, Q4_K_M теряет немного, Q3_K_M — заметнее, Q2_K — явно. Это чужие замеры: мы качество не измеряли.
| Формат | Бит на параметр | Gemma 3 27B, MMLU 5-shot, % | LLaMA 7B, перплексия |
|---|---|---|---|
| BF16 / F16 | 16 | 71,5 | 5,9066 |
| Q8_0 | 8,5 | 71,60 | — |
| Q6_K | 6,56 | 71,87 | 5,9110 |
| Q5_K_M | 5,68 | 71,77 | 5,9208 |
| Q4_K_M | 4,84 | 71,23 | 5,9601 |
| Q3_K_M | 3,9 | 70,70 | 6,1503 |
| Q2_K | 3 | 68,50 | 6,7764 |
Источники: документация Unsloth Dynamic 2.0 (Gemma 3 27B) и запрос №1684 к llama.cpp (LLaMA 7B; чем ниже перплексия, тем лучше). Перплексия растёт медленно до Q4_K_M (5,96 против 5,91) и резко у Q2_K (6,78).
У замеров есть границы. Обе модели старые, тест у каждой один, и он не покажет, как формат скажется на коде, математике или русском языке. Различия в десятые доли пункта — шум: Q6_K набрал больше Q8_0. Проверьте файл на своих запросах: на арендованной карте это час работы.
Что даёт квантизация кэша контекста?
Кэш контекста тоже можно сжать вдвое, не трогая веса. Кэш — это память, где модель хранит ключи и значения уже прочитанных токенов; он растёт вместе с диалогом. У Llama 3.3 70B в Q4_K_M кэш на 32K токенов занимает 10,0 ГБ в FP16 и 5,3 ГБ в q8.
- 8K, кэш FP1643,1 ГБ
- 32K, кэш FP1650,6 ГБ
- 32K, кэш q845,9 ГБ
- 128K, кэш FP1680,6 ГБ
- 128K, кэш q861,8 ГБ
С контекстом 32K Llama 3.3 70B занимает 50,6 ГБ и идёт на карту 80 ГБ. С кэшем q8 — 45,9 ГБ: хватает 48 ГБ, но впритык. При 128K выигрыш ещё нагляднее: карта 96 ГБ превращается в 80 ГБ.
Если кэш мал, выгода скромнее. У Qwen3.8 27B кэш q8 экономит при 8K всего 0,23 ГБ, при 128K — 3,8 ГБ, и этого хватает, чтобы перейти с карты 32 ГБ на 24 ГБ.
# llama.cpp
llama-server -hf unsloth/Qwen3-8B-GGUF:Q4_K_M -ctk q8_0 -ctv q8_0 -fa on

# vLLM
vllm serve <модель> --kv-cache-dtype fp8

# Ollama: переменные окружения сервера
OLLAMA_KV_CACHE_TYPE=q8_0
OLLAMA_FLASH_ATTENTION=1
Цена — точность. Документация Ollama называет потерю у q8_0 «очень небольшой», у q4_0 — «малой или средней»; тип кэша там один на все модели. vLLM предупреждает, что слои со скользящим окном, как у Gemma 4, к сжатию чувствительнее.
Какой формат выбрать?
Начните с Q4_K_M. Если памяти хватает, берите Q8_0 или FP8; ниже Q4 опускайтесь, только когда иначе файл не помещается.
- Памяти хватает. Q8_0 в замерах выше почти не отличается от исходной модели; аналог для vLLM — FP8, его в замерах нет. Qwen3.8 27B с 8K: Q8_0 — 28,9 ГБ, FP8 — 30,6 ГБ, карта 32 ГБ.
- Обычный случай. Q4_K_M. Qwen3 8B занимает 6,8 ГБ, Gemma 4 31B — 19,7 ГБ, Qwen3.8 27B — 17,2 ГБ, Llama 3.3 70B — 43,1 ГБ: это карты 8 ГБ, 24 ГБ, 24 ГБ и 48 ГБ.
- Карты не хватает. Ниже Q4_K_M имеет смысл спускаться, только если файл перешагнёт ступень. Llama 3.3 70B в Q3_K_M (35,4 ГБ) всё равно идёт на 48 ГБ, как и Q4_K_M: выигрыша нет. Q2_K (28,1 ГБ) помещается на 32 ГБ, но потери у него самые большие.
- vLLM. Берите FP8 на картах Ada, Hopper и Blackwell и AWQ, когда нужны 4 бита. Для GPT-OSS выбирать не из чего: модель вышла в MXFP4.
Посчитайте свою конфигурацию
Выберите модель, формат и длину контекста — калькулятор покажет память и карты каталога, на которых модель запустится дешевле всего. Правило расчёта — в гайде про VRAM для LLM, таблица по 35 моделям — в статье «Сколько видеопамяти нужно открытым LLM».
Как скачать нужный квант на арендованной видеокарте
Шаблон Open WebUI + Ollama берёт GGUF прямо с Hugging Face: имя пишется как hf.co/организация/репозиторий:квант. Примеры — для Qwen3 8B: в Q8_0 ей нужно 10,3 ГБ (карта 12 ГБ), в Q4_K_M — 6,8 ГБ (карта 8 ГБ).
Выберите карту по таблице памяти
Найдите в таблице выше свою модель и формат, откройте каталог и нажмите «Арендовать». Выберите шаблон Open WebUI + Ollama: он работает на картах от 8 ГБ.
Впишите модель и квант в поле «Модель»
Диск возьмите от 40 ГБ и с запасом сверх размера файла. Если нужного тега нет, подставьте имя файла целиком: Ollama принимает и его.
hf.co/unsloth/Qwen3-8B-GGUF:Q8_0Подождите, пока файл скачается
Шаблон скачивает модель при первом старте, обычно за 3–10 минут; крупный квант дольше. О готовности чата придёт сообщение.
Сравните другой квант той же модели
Подключитесь по SSH, скачайте второй файл и запустите его. Лишнюю модель удалите командой ollama rm.
ollama pull hf.co/unsloth/Qwen3-8B-GGUF:Q4_K_M ollama run hf.co/unsloth/Qwen3-8B-GGUF:Q4_K_M ollama rm hf.co/unsloth/Qwen3-8B-GGUF:Q8_0Остановите сервер, когда закончили
Остановка прекращает оплату GPU, а диск с файлами тарифицируется, пока вы не удалили сервер.
Для vLLM возьмите FP8-чекпойнт и включите FP8-кэш. Запуск — как в шаблоне vLLM, с другой моделью и флагом:
pkill -f api_server
nohup python3 -m vllm.entrypoints.openai.api_server --host 0.0.0.0 --port 8000 \
  --model Qwen/Qwen3-8B-FP8 --kv-cache-dtype fp8 --max-model-len 8192 \
  --api-key <токен аренды> > /var/log/vllm.log 2>&1 &
Что может пойти не так
- Квант не поместился в видеопамять. Ollama и llama.cpp положат часть слоёв в оперативную память, и ответы станут заметно медленнее. Долю видно в колонке Processor команды ollama ps.
- Пересжатие чужого файла. README llama.cpp предупреждает: повторная квантизация (--allow-requantize) «может сильно ухудшить качество» по сравнению с квантизацией из 16 бит. Берите готовый файл.
- Одно имя, разные файлы. Q4_K_M у разных авторов отличается рецептом и размером. Сверяйте размер файла в репозитории, а не только название.
- LM Studio пишет «No LM Runtime found for model format gguf». Судя по тексту, дело в рантайме, а не в файле. GGUF там запускает движок llama.cpp: откройте менеджер рантаймов (Ctrl+Shift+R) и проверьте, что подходящий установлен. Официального разбора ошибки мы не нашли.
Как мы считали
Веса — реальные размеры файлов: GGUF и FP8 из репозиториев Hugging Face (в основном unsloth и Qwen), BF16 — из оригинальных. У Qwen3.8 27B в репозитории unsloth нет простых Q4_K_M, Q5_K_M и Q6_K (список файлов проверен 2026-10-20). В таблицах стоят их динамические варианты: UD-Q4_K_M, UD-Q5_K_M и UD-Q6_K. Кэш контекста посчитан по config.json модели; кэш q8 — как 8,5 бита на значение (q8_0 в llama.cpp), а у FP8-кэша vLLM 8 бит, то есть на 6% меньше. 1 ГБ здесь — 1024³ байт, как у видеокарт; Hugging Face показывает десятичные гигабайты, и его цифры примерно на 7% больше. Данные на 2026-10-19; методика — в калькуляторе.
Описания форматов сверены с первоисточниками 2026-10-20: README и запрос №1684 llama.cpp, спецификация GGUF, документация Hugging Face, Ollama, vLLM и Unsloth, карточка модели GPT-OSS. Для сверки: в таблице README llama.cpp Q4_K_M у Llama 3.1 8B — 4,89 бита на вес, по нашим файлам у Qwen3 8B выходит 4,91, у Llama 3.3 70B — 4,82.
Вопросы и ответы
- Что такое GGUF?
- GGUF — формат файла для запуска языковых моделей в llama.cpp, Ollama и LM Studio. В одном файле лежат веса и метаданные: токенизатор, параметры архитектуры, шаблон чата. Сжатие весов — отдельный выбор, оно указано в имени файла, например Q4_K_M или Q8_0.
- Что значит Q4_K_M?
- Это 4-битная k-квантизация со средним вариантом смеси: большая часть весов хранится в 4 битах, часть тензоров — в 6. В среднем выходит 4,84 бита на параметр, то есть в 3,3 раза меньше, чем в 16-битном BF16. Ollama и llama.cpp берут Q4_K_M по умолчанию.
- Какую квантизацию выбрать: Q4_K_M, Q5_K_M или Q8_0?
- Начните с Q4_K_M: Qwen3.8 27B в ней идёт на карту 24 ГБ. Q8_0 берите, если памяти хватает: в опубликованных замерах она почти не отличается от исходной модели, но для той же 27B нужна карта 32 ГБ. Q3_K_M и Q2_K имеют смысл, только когда файл иначе не помещается.
- Сколько памяти экономит квантизация?
- Q4_K_M уменьшает веса в 3,3 раза по сравнению с BF16: у Qwen3.8 27B с 50,9 ГБ до 15,3 ГБ. Вместе с контекстом 8K и служебной памятью это 17,2 ГБ против 52,8 ГБ, то есть карта 24 ГБ вместо 80 ГБ.
- Как скачать GGUF с Hugging Face в Ollama?
- Выполните ollama run hf.co/организация/репозиторий:квант, например hf.co/unsloth/Qwen3-8B-GGUF:Q8_0. Без указания кванта Ollama берёт Q4_K_M, если он есть в репозитории. На сервере gpu.nz то же имя вписывается в поле «Модель» шаблона Open WebUI + Ollama.
- Что значит ошибка LM Studio «No LM Runtime found for model format gguf»?
- Судя по тексту, для формата GGUF в LM Studio не найден рантайм, то есть дело не в самом файле. GGUF там запускает движок llama.cpp: откройте менеджер рантаймов сочетанием Ctrl+Shift+R и проверьте, что подходящий рантайм установлен. Официального разбора ошибки мы не нашли.


