9 мин чтения ·
GLM-5.3 Flash: сколько нужно VRAM и какие GPU подойдут
GLM-5.3 Flash в Q4 занимает 187,3 ГБ VRAM: 2 карты H200 или 4 карты по 80 ГБ. Q2 — 102,6 ГБ. Какие GPU подойдут, ОЗУ, запуск.
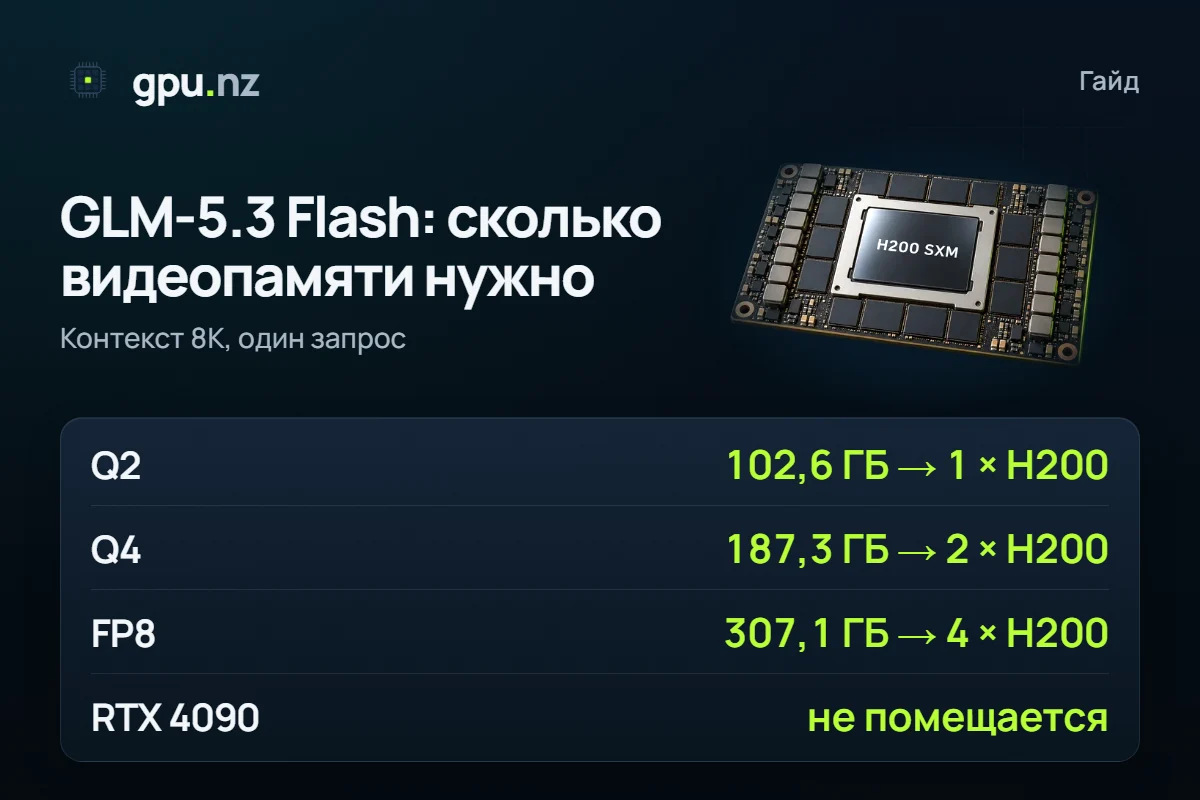
GLM-5.3 Flash в Q4 занимает 187,3 ГБ видеопамяти при контексте 8K: это 2 карты по 141 ГБ (H200) или 4 карты по 80 ГБ с запасом. Q2 сжимает модель до 102,6 ГБ, и её вмещает одна H200 (занято 75% памяти). Одна RTX 4090 на 24 ГБ не подходит ни с одной квантизацией: даже Q2 требует 8 таких карт.
- Q4 (UD-Q4_K_XL), контекст 8K
- 187,3 ГБ
- Q4 (UD-Q4_K_XL), контекст 8K
- минимум карт H200 для Q4
- 2 × 141 ГБ
- минимум карт H200 для Q4
- Q2: одна карта на 141 ГБ
- 102,6 ГБ
- Q2: одна карта на 141 ГБ
- оригинальные веса FP8
- 307,1 ГБ
- оригинальные веса FP8
Сколько видеопамяти нужно GLM-5.3 Flash
В Q4 — 187,3 ГБ, в Q2 — 102,6 ГБ, в Q6 — 273,1 ГБ. Это память под веса, кэш контекста 8K и служебные буферы для одного запроса. Квантизация — сжатие весов: чем меньше бит на вес, тем меньше памяти и тем обычно заметнее потеря качества. Подробнее — в гайде про квантизацию GGUF.
- Q2UD-Q2_K_XL102,6 ГБ
- Q4UD-Q4_K_XL187,3 ГБ
- Q6UD-Q6_K_XL273,1 ГБ
- FP8оригинальные веса307,1 ГБ
Оригинальные веса в FP8 занимают 307,1 ГБ, в BF16 — 598,9 ГБ. По карточке модели на Hugging Face у GLM-5.3 Flash около 320 млрд параметров, из них на каждый токен задействованы 18 млрд; счётчик Hugging Face показывает 321 млрд. Лицензия MIT, модель мультимодальная. Но в памяти должны лежать все 320 млрд, а не 18: активные параметры ускоряют ответ, число карт они не сокращают.
Для сравнения: DeepSeek V4 Flash в Q4 занимает 145,5 ГБ, это 2 карты H200 против 2 карты у GLM. Её разбор — в гайде про DeepSeek V4 Flash. Размеры всех версий GLM — на странице GLM-5.3 Flash.
Какие GPU нужны для GLM-5.3 Flash
Веса и кэш делятся между картами поровну (тензорный параллелизм), а служебная память CUDA нужна на каждой. Мы берём наименьшее число карт из 1, 2, 4 и 8, при котором модель помещается. В ячейке — сколько карт такого размера нужно; прочерк — не хватает и восьми.
| Квантизация | 24 ГБ | 48 ГБ | 80 ГБ | 96 ГБ | 141 ГБ |
|---|---|---|---|---|---|
| Q2 UD-Q2_K_XL · 102,6 ГБ | 8 | 4 | 2 | 2 | 1 |
| Q4 UD-Q4_K_XL · 187,3 ГБ | — | 8 | 4 | 4 | 2 |
| Q6 UD-Q6_K_XL · 273,1 ГБ | — | 8 | 4 | 4 | 2 впритык |
| Оригинал FP8 FP8 · 307,1 ГБ | — | 8 | 4 впритык | 4 | 4 |
| BF16 BF16 · 598,9 ГБ | — | — | 8 впритык | 8 | 8 |
Пометка «впритык» — занято больше 92% памяти карты: модель запустится, но длинный запрос может не поместиться. Самые маленькие реалистичные конфигурации:
- Q2: 1 карта на 141 ГБ (75% памяти) или 2 карты по 80 ГБ. Это самый дешёвый вариант, но качество Q2 мы не измеряли.
- Q4: 2 карты H200 (69% памяти каждой) или 4 карты по 80 ГБ. Это основной вариант для работы.
- Оригинал FP8: 4 карты H200. Рецепт vLLM для этой модели берёт 8 × H200, на 80 ГБ нужны 4 карты, но впритык.
- Карты по 24 и 48 ГБ: Q2 помещается на 8 и 4 картах, Q4 — на 8 картах по 48 ГБ. Чем больше карт, тем сильнее скорость зависит от связи между ними. Мы её не мерили.
Это расчёт по памяти. Рецепт vLLM (recipes.vllm.ai) по умолчанию описывает 8 × H200 с тензорным параллелизмом и FP8 и называет минимумом видеокарты поколения Hopper и новее. Конфигурации на двух и четырёх картах мы не запускали.
Почему не хватит одной RTX 4090 или V100
Память одной карты слишком мала для весов: файл Q2 весит 109 ГБ, а у RTX 4090 — 24 ГБ. Q2 уместится только на 8 таких картах, Q4 — не уместится и на восьми. У Tesla V100 бывает 16 и 32 ГБ: для Q2 нужно 8 и 4 карт соответственно.
| Карта | Q2, нужно карт | Q4, нужно карт |
|---|---|---|
| Tesla V100 16 16 ГБ | 8 | не хватает и 8 |
| Tesla V100 32 32 ГБ | 4 | 8 |
| RTX 4090 24 ГБ | 8 | не хватает и 8 |
| RTX 6000 Ada / RTX A6000 48 ГБ | 4 | 8 |
| H100 / A100 80 ГБ | 2 | 4 |
| H200 141 ГБ | 1 | 2 |
Дело не только в объёме. Рецепт vLLM называет минимумом Hopper и новее, а V100 — это архитектура Volta, куда старше. Проще взять одну H200 с Q2 или две H200 с Q4, чем собирать восемь старых карт. Серверы ищите в каталоге.
Сколько оперативной памяти нужно GLM-5.3 Flash
Если вся модель лежит на видеокартах, оперативная память не главное ограничение: считайте по видеопамяти. Другое дело — выгрузка слоёв в ОЗУ. llama.cpp умеет держать часть слоёв в оперативной памяти: число слоёв на видеокарте задаёт параметр -ngl. Модель так запускается на меньшем числе карт, но медленно: слои из ОЗУ идут через шину PCIe и процессор. Скорость мы не мерили.
Грубая оценка: всё, что не поместилось в видеопамять, должно лежать в ОЗУ, плюс место под систему. С одной RTX 4090 это около 79 ГБ для Q2 и около 164 ГБ для Q4. Сервер с такой оперативной памятью и одной картой на 24 ГБ найти проще, чем сервер с несколькими H200, но ответы будут заметно медленнее.
Сколько добавляет длинный контекст
Немного. По оценке калькулятора кэш контекста GLM-5.3 Flash — около 11,3 КБ на токен плюс постоянная часть. Контекст 128K добавляет 1,3 ГБ, а весь миллион токенов — 10,9 ГБ. Это оценка по архитектуре, а не замер.
| Контекст | Кэш | Всего, Q4 | Карт по 80 ГБ | Карт по 141 ГБ |
|---|---|---|---|---|
| 8K | 0,27 ГБ | 187,3 ГБ | 4 | 2 |
| 128K | 1,6 ГБ | 188,6 ГБ | 4 | 2 |
| 1M | 11,2 ГБ | 198,2 ГБ | 4 | 2 |
Миллион токенов в Q4 — 198,2 ГБ: по-прежнему 2 карты H200 или 4 карты по 80 ГБ. Предел в 1M токенов взят из наших данных; в карточке модели на Hugging Face длина контекста прямо не указана.
Посчитайте свою конфигурацию
Выберите модель, квантизацию и длину контекста: калькулятор покажет память и серверы из каталога с нужным числом карт, самые дешёвые первыми. Контекст в нём доходит до 128K.
Во сколько обойдётся час
Цена часа — число карт, умноженное на цену одной. Для Q4 это 2 карты по 141 ГБ или 4 карты по 80 ГБ. Цены меняются каждую минуту, поэтому ниже живые карточки: H200 и H100 подходят по памяти.
Как запустить GLM-5.3 Flash на арендованном сервере
Готового шаблона с этой моделью у нас нет, запуск ручной. На карточке Hugging Face есть команды для vLLM и SGLang, а рецепт vLLM описывает полную раскладку. В библиотеке Ollama на 2026-11-06 есть только тег glm-5.3-flash:cloud: он работает на удалённой стороне, а не на вашей видеокарте, поэтому локально через Ollama модель не запустить. Файлы GGUF для llama.cpp выпускает unsloth.
Подключитесь по SSH
Команда подключения — на странице сервера. Шаблон сначала запустит свою модель по умолчанию; её мы сейчас заменим.
Замените модель на GLM-5.3 Flash
В --api-key укажите токен аренды. Флаги и переменные взяты из рецепта vLLM; он требует vLLM 0.29.0 или новее.
pkill -f api_server export VLLM_USE_RUST_FRONTEND=1 export VLLM_ENGINE_READY_TIMEOUT_S=3600 nohup vllm serve zai-org/GLM-5.3-Flash --host 0.0.0.0 --port 8000 \ --api-key <токен аренды> --tokenizer-mode glm5_next --tensor-parallel-size 8 \ --disable-flashinfer-autotune --tool-call-parser glm47 --enable-auto-tool-choice \ --reasoning-parser glm47 > /var/log/vllm.log 2>&1 & tail -f /var/log/vllm.logДождитесь загрузки
Модель скачивается и компилируется: это дольше, чем у маленьких моделей. Сервер готов, когда в логе появится строка о запуске API.
Отправьте запрос
Адрес API — кнопка «API (порт 8000)» на странице сервера. Имя модели в запросе совпадает с аргументом vllm serve.
curl https://<id>-8000.run.gpu.nz/v1/chat/completions \ -H "Authorization: Bearer <токен>" \ -H "Content-Type: application/json" \ -d '{"model": "zai-org/GLM-5.3-Flash", "messages": [{"role": "user", "content": "Привет"}]}'Удалите сервер, когда закончили
Оплата поминутная. Сохраните нужные результаты и удалите сервер — тогда списания прекратятся совсем. Остановленный сервер платит только за диск, но восемь карт за это время может арендовать другой клиент.
Первая загрузка идёт на оплаченном сервере
Вы платите за все карты сервера, пока он работает, и загрузка в это время тоже идёт. Файлы весят 109–328 ГБ: при скорости 1 Гбит/с оригинал качается не меньше 44 мин, на деле дольше. Удалите диск, и в следующий раз модель придётся качать заново.
Для одного пользователя и меньшего числа карт соберите llama.cpp на шаблоне Ubuntu + CUDA и возьмите файл GGUF (Q2 — одна H200, Q4 — две). По странице unsloth для этой модели нужна сборка llama.cpp с pull request №27754: проверьте, вошёл ли он в релиз. llama.cpp сам делит слои между всеми видимыми картами:
apt-get update && apt-get install -y build-essential cmake git curl libcurl4-openssl-dev
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --target llama-server
./llama.cpp/build/bin/llama-server -hf unsloth/GLM-5.3-Flash-GGUF:UD-Q4_K_XL \
--port 8080 -ngl 99 --ctx-size 32768У шаблона Ubuntu нет веб-адресов, поэтому пробросьте порт по SSH с вашего компьютера и откройте http://localhost:8080:
ssh -p <порт> -L 8080:localhost:8080 root@<адрес>Что может пойти не так
- Версия vLLM. Рецепт требует vLLM 0.29.0 и новее, а также свежий FlashInfer. Версию в шаблоне проверит команда python3 -c "import vllm; print(vllm.__version__)"; при старой версии обновите vLLM до запуска.
- Картинки и видео. Рецепт отмечает, что Rust-фронтенд не принимает изображения и видео. Для них запускайте vLLM с VLLM_USE_RUST_FRONTEND=0.
- Параллельные запросы умножают кэш. Цифры выше — для одного запроса. В vLLM каждый одновременный запрос держит свой кэш, и vLLM по умолчанию занимает до 90% памяти карты. Для API выбирайте конфигурации без пометки «впритык». На Hopper (H100, H200) рецепт требует кэш в BF16, как и в нашем расчёте.
- Скорость мы не мерили. Все цифры — расчёт по памяти. Скорость ответа зависит от числа карт, связи между ними и выгрузки в ОЗУ, поэтому проверьте её на своём сервере, прежде чем вставлять модель в сервис.
Как мы считали
Веса — реальные размеры файлов на Hugging Face: GGUF из unsloth/GLM-5.3-Flash-GGUF (UD-Q4_K_XL стоит в калькуляторе на месте Q4_K_M) и оригинал FP8 из zai-org/GLM-5.3-Flash. Кэш контекста — оценка калькулятора, 11,3 КБ на токен. Служебная память — около 0,75 ГБ плюс буфер логитов на каждой карте. При нескольких GPU веса и кэш делятся поровну.
1 ГБ здесь — 1024³ байт, как у видеокарт, а Hugging Face показывает десятичные гигабайты: 328 ГБ вместо 305,8. Число параметров — по счётчику Hugging Face (карточка называет 320 млрд). Активные параметры, лицензия и команды — из карточки модели, рецепта vLLM и страницы unsloth, прочитанных 2026-11-06. Данные на 2026-10-19; методика — в калькуляторе, сводная таблица по 35 моделям — в статье «Сколько видеопамяти нужно открытым LLM». Общее правило расчёта — в гайде сколько видеопамяти нужно для LLM.
Вопросы и ответы
- Сколько VRAM нужно GLM-5.3 Flash?
- В квантизации Q4 при контексте 8K — 187,3 ГБ, в Q2 — 102,6 ГБ, в оригинале FP8 — 307,1 ГБ. Это расчёт для одного запроса: веса, кэш и служебная память.
- Какие GPU нужны для GLM-5.3 Flash?
- Для Q4 — 2 карты по 141 ГБ (H200) или 4 карты по 80 ГБ с запасом. Для Q2 хватит одной карты на 141 ГБ, для оригинала FP8 нужно 4 карты H200, а рецепт vLLM берёт 8.
- Запустится ли GLM-5.3 Flash на RTX 4090 или V100?
- Не на одной карте. RTX 4090 имеет 24 ГБ, и даже Q2 требует 8 таких карт. У V100 бывает 16 и 32 ГБ, для Q2 нужно 8 и 4 карт. Проще взять одну H200 с Q2.
- Сколько оперативной памяти нужно GLM-5.3 Flash?
- Если модель целиком на видеокартах, считайте по видеопамяти. При выгрузке слоёв в ОЗУ через llama.cpp в оперативной памяти должно лежать всё, что не влезло в GPU: с одной картой на 24 ГБ это около 79 ГБ для Q2 и 164 ГБ для Q4. Ответы при этом заметно медленнее.
- Есть ли GLM-5.3 Flash в Ollama?
- На 2026-11-06 в библиотеке Ollama есть только тег glm-5.3-flash:cloud. Он работает на удалённой стороне, а не на вашей видеокарте, поэтому локально через Ollama модель не запустить.
- Поддерживает ли vLLM GLM-5.3 Flash?
- Да. Рецепт vLLM описывает запуск на 8 картах H200 в FP8 и требует vLLM 0.29.0 или новее и видеокарты Hopper и новее. Команда vllm serve есть и на карточке модели на Hugging Face.


