9 мин чтения ·
ИИ на слабом ПК: какие модели влезут в 6, 8, 12 и 16 ГБ VRAM
Qwen3.5 4B влезает в 6 ГБ, 9B — в 8 ГБ, Qwen3 14B — в 12 ГБ. Таблица по картам и ОЗУ: что запустится и когда арендовать.
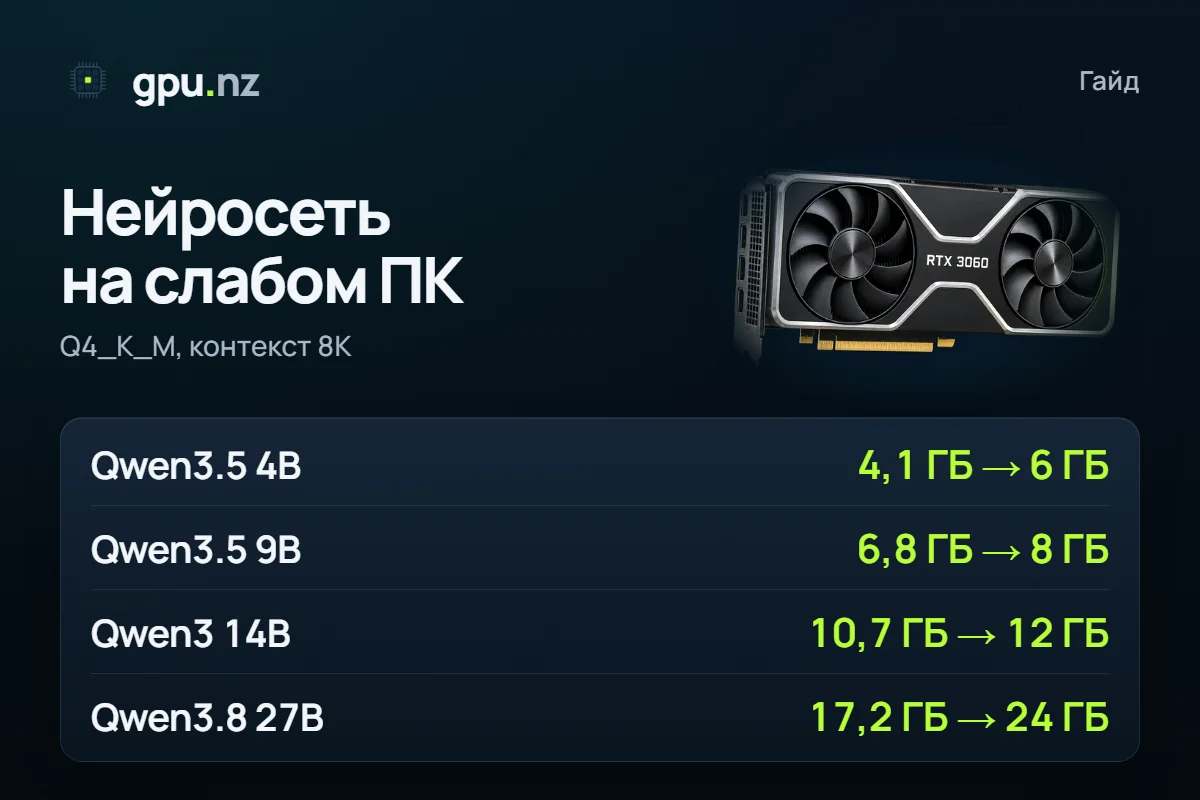
Какая модель запустится на слабом ПК, решает видеопамять (VRAM). В квантизации Q4_K_M при контексте 8K Qwen3.5 4B занимает 4,1 ГБ, Qwen3.5 9B — 6,8 ГБ, Qwen3 14B — 10,7 ГБ, Qwen3.8 27B — 17,2 ГБ. Значит, на карту 6 ГБ целиком влезает Qwen3.5 4B, на 8 ГБ добавляются модели до 9B, а на 12 ГБ — Gemma 4 12B и Qwen3 14B. Если не хватает, модель уйдёт частью в оперативную память (ОЗУ) и станет заметно медленнее.
- Qwen3.5 4B: карта 6 ГБ
- 4,1 ГБ
- Qwen3.5 4B: карта 6 ГБ
- Qwen3.5 9B: карта 8 ГБ
- 6,8 ГБ
- Qwen3.5 9B: карта 8 ГБ
- Qwen3 14B: карта 12 ГБ
- 10,7 ГБ
- Qwen3 14B: карта 12 ГБ
- Qwen3.8 27B: карта 24 ГБ
- 17,2 ГБ
- Qwen3.8 27B: карта 24 ГБ
Что помещается в 6, 8, 12 и 16 ГБ видеопамяти?
Ответ в таблице: слева объём памяти вашей карты, справа модели, которые помещаются в неё целиком в Q4_K_M при контексте 8K. Контекст — это память под уже прочитанный текст разговора; 8K токенов — несколько страниц. Мы взяли 8 моделей, о которых чаще всего спрашивают.
| Видеопамять | Примеры карт | Целиком помещается (Q4_K_M, 8K; в скобках ГБ памяти) | Что добавилось |
|---|---|---|---|
| 6 ГБ | RTX 3050 6 ГБ, GTX 1660 | Qwen3.5 4B (4,1) | Qwen3.5 4B |
| 8 ГБ | RTX 4060, RTX 3060 Ti | Qwen3.5 4B (4,1) Llama 3.1 8B (6,6) Qwen3.5 9B (6,8) Qwen3 8B (6,8) | Llama 3.1 8B Qwen3.5 9B Qwen3 8B |
| 12 ГБ | RTX 3060 12 ГБ | Qwen3.5 4B (4,1) Llama 3.1 8B (6,6) Qwen3.5 9B (6,8) Qwen3 8B (6,8) Gemma 4 12B (8,3) Qwen3 14B (10,7) | Gemma 4 12B Qwen3 14B |
| 16 ГБ | RTX 4060 Ti 16 ГБ | Qwen3.5 4B (4,1) Llama 3.1 8B (6,6) Qwen3.5 9B (6,8) Qwen3 8B (6,8) Gemma 4 12B (8,3) Qwen3 14B (10,7) GPT-OSS 20B (12,6) | GPT-OSS 20B |
| 24 ГБ | RTX 3090, RTX 4090 | Qwen3.5 4B (4,1) Llama 3.1 8B (6,6) Qwen3.5 9B (6,8) Qwen3 8B (6,8) Gemma 4 12B (8,3) Qwen3 14B (10,7) GPT-OSS 20B (12,6) Qwen3.8 27B (17,2) | Qwen3.8 27B |
- Qwen3.5 4B4,1 ГБ
- Llama 3.1 8B6,6 ГБ
- Qwen3.5 9B6,8 ГБ
- Qwen3 8B6,8 ГБ
- Gemma 4 12B8,3 ГБ
- Qwen3 14B10,7 ГБ
- GPT-OSS 20BMoE12,6 ГБ
- Qwen3.8 27B17,2 ГБ
12 ГБ — запрос «12gb vram» про эту ступень. Здесь работают Qwen3.5 4B, Llama 3.1 8B, Qwen3.5 9B, Qwen3 8B, Gemma 4 12B и Qwen3 14B. Qwen3 14B занимает 10,7 ГБ, то есть почти всю карту: длинный разговор уже не поместится. На 16 ГБ добавляется GPT-OSS 20B.
Целиком в видеопамяти — главное условие. Модели Qwen3.5 9B, Qwen3 8B и Llama 3.1 8B занимают около 6,8 ГБ, поэтому 8 ГБ хватает с небольшим запасом. Но Qwen3 8B с контекстом 32K требует уже 10,2 ГБ и карту 12 ГБ: кэш у него растёт быстрее, чем у Qwen3.5.
Сколько весит модель: размер файла в гигабайтах
Файл модели меньше, чем память, которая нужна для работы: к весам добавляются кэш контекста и служебная память CUDA. Файл Qwen3.5 4B в Q4_K_M — 2,6 ГБ, Qwen3 8B — 4,7 ГБ, Llama 3.1 8B — 4,6 ГБ. Диск и скачивание считайте по колонкам «Файл», видеопамять — по последней.
| Модель | Параметры | Файл Q4_K_M | Файл Q8_0 | Файл BF16 | Память при 8K, Q4_K_M |
|---|---|---|---|---|---|
| Qwen3.5 4B | 4,7 млрд | 2,6 ГБ | 4,2 ГБ | 7,8 ГБ | 4,1 ГБ |
| Llama 3.1 8B | 8 млрд | 4,6 ГБ | — | 15,0 ГБ | 6,6 ГБ |
| Qwen3.5 9B | 9,7 млрд | 5,3 ГБ | 8,9 ГБ | 16,7 ГБ | 6,8 ГБ |
| Qwen3 8B | 8,2 млрд | 4,7 ГБ | 8,1 ГБ | 15,3 ГБ | 6,8 ГБ |
| Gemma 4 12B | 12 млрд | 6,6 ГБ | 11,8 ГБ | 22,2 ГБ | 8,3 ГБ |
| Qwen3 14B | 14,8 млрд | 8,4 ГБ | 14,6 ГБ | 27,5 ГБ | 10,7 ГБ |
| GPT-OSS 20B | 20,9 млрд | 11,3 ГБ MXFP4 | — | — | 12,6 ГБ |
| Qwen3.8 27B | 27,8 млрд | 15,3 ГБ | 27,1 ГБ | 50,9 ГБ | 17,2 ГБ |
Q8_0 почти вдвое тяжелее Q4_K_M, BF16 — это оригинальный размер модели без сжатия. У GPT-OSS 20B файл один, в родном формате MXFP4. Подробнее, что значат эти буквы, — в статье «Квантизация GGUF». Размеры здесь в ГиБ (1024³ байт), как показывают видеокарты; в магазинах моделей они могут выглядеть чуть больше.
Как узнать, сколько у вас видеопамяти
Есть два быстрых способа: диспетчер задач в Windows и команда nvidia-smi для карт NVIDIA.
- Диспетчер задач Windows. Нажмите Ctrl+Shift+Esc, откройте «Производительность» и выберите видеокарту (GPU 0, GPU 1). Нужна строка «Выделенная память…» (точная подпись зависит от версии Windows). Это и есть VRAM карты.
- Не путайте с общей памятью. Строка «Общая память» — это часть обычной ОЗУ, которую видеокарта может занять. Это не видеопамять карты, её в объём VRAM не считайте. В ноутбуках бывает две карты: встроенная и дискретная, нужна дискретная.
- nvidia-smi (Windows и Linux, карты NVIDIA). Откройте терминал и выполните команду ниже. Объём выводится в МиБ: разделите на 1024, чтобы получить ГиБ. Число может оказаться чуть меньше круглого: часть памяти занимает драйвер.
nvidia-smi --query-gpu=name,memory.total --format=csvУ карт AMD и Intel этой команды нет, там смотрите диспетчер задач или программу производителя.
Влезет ли Qwen3.5 «7B» в 6 ГБ?
Модели Qwen3.5 7B в нашей таблице нет: у семейства есть версии 4B и 9B. Qwen3.5 4B занимает 4,1 ГБ и спокойно помещается в 6 ГБ (RTX 3050). Qwen3.5 9B в Q4_K_M требует 6,8 ГБ, это карта 8 ГБ.
Можно ужать 9B ещё сильнее. В таблице ниже видно: в Q3_K_M она занимает 5,9 ГБ, в Q2 — 5,4 ГБ. Только Q2 помещается в 6 ГБ. Чем сильнее сжатие, тем заметнее падает качество ответов. Мы его не измеряли, поэтому честный выбор такой: 4B в Q4_K_M или 9B в Q2, и стоит проверить обе на своих задачах.
| Модель (контекст 8K) | Q8_0 | Q6_K | Q4_K_M | Q3_K_M | Q2 |
|---|---|---|---|---|---|
| Qwen3.5 9B | 10,4 ГБ карта 12 ГБ | 8,5 ГБ карта 12 ГБ | 6,8 ГБ карта 8 ГБ | 5,9 ГБ карта 8 ГБ | 5,4 ГБ карта 6 ГБ |
| Gemma 4 12B | 13,5 ГБ карта 16 ГБ | 10,8 ГБ карта 12 ГБ | 8,3 ГБ карта 12 ГБ | 7,0 ГБ карта 8 ГБ | 6,0 ГБ карта 8 ГБ |
| Llama 3.1 8B | — | 8,1 ГБ карта 12 ГБ | 6,6 ГБ карта 8 ГБ | 5,7 ГБ карта 6 ГБ | 5,0 ГБ карта 6 ГБ |
У Q2 в строках Qwen3.5 и Gemma 4 — динамический вариант UD-Q2_K_XL, у Llama 3.1 — обычный Q2_K. Gemma 4 12B в Q3_K_M занимает 7,0 ГБ и влезает в 8 ГБ, а в Q2 (6,0 ГБ) — всё равно не в 6 ГБ.
Что даёт оперативная память: 16 и 32 ГБ ОЗУ
Модель, которая не поместилась в видеопамять, можно запустить с помощью ОЗУ. llama.cpp и Ollama умеют держать часть слоёв модели на видеокарте, а остальные — в обычной памяти и считать их на процессоре. Это работает, но заметно медленнее: эти слои считает процессор, а он работает с обычной памятью, которая медленнее видеопамяти. Своих замеров скорости у нас нет, цифр не называем.
- Ollama. Команда `ollama ps` показывает в колонке PROCESSOR, где лежит модель: `100% GPU` — целиком на карте, `100% CPU` — целиком в системной памяти, `48%/52% CPU/GPU` — частично там и там. Так сказано в FAQ Ollama.
- llama.cpp. Флаг `-ngl` (`--n-gpu-layers`) задаёт, сколько слоёв хранить в видеопамяти. По справке llama.cpp, значение по умолчанию — auto; число можно задать самому.
Сколько ОЗУ нужно модели, считаем так же, как видеопамять: веса плюс кэш контекста. Из 16 или 32 ГБ вычитаем 8 ГБ под Windows, браузер и остальные программы. Это наше допущение, а не замер, у вас запас может быть другим.
| Модель | Память при 8K | 16 ГБ ОЗУ | 32 ГБ ОЗУ |
|---|---|---|---|
| Qwen3.5 4B | 4,1 ГБ | хватает | хватает |
| Llama 3.1 8B | 6,6 ГБ | хватает | хватает |
| Qwen3.5 9B | 6,8 ГБ | хватает | хватает |
| Qwen3 8B | 6,8 ГБ | хватает | хватает |
| Gemma 4 12B | 8,3 ГБ | не хватает | хватает |
| Qwen3 14B | 10,7 ГБ | не хватает | хватает |
| GPT-OSS 20B | 12,6 ГБ | не хватает | хватает |
| Qwen3.8 27B | 17,2 ГБ | не хватает | хватает |
| Qwen3 30B-A3B | 19,1 ГБ | не хватает | хватает |
| Qwen3 32B | 21,4 ГБ | не хватает | хватает |
| Qwen3 Next 80B-A3B | 46,5 ГБ | не хватает | не хватает |
Какую Qwen взять при 32 ГБ ОЗУ. По этой таблице помещаются Qwen3 32B (21,4 ГБ), Qwen3 Coder 30B-A3B (19,1 ГБ), Qwen3 30B-A3B (19,1 ГБ), Qwen3.8 27B (17,2 ГБ) и Qwen3 14B (10,7 ГБ). Начните с Qwen3.8 27B: она самая новая в таблице. Не помещается Qwen3 Next 80B-A3B: ему нужно 46,5 ГБ. Длинный контекст тоже съест запас: у Qwen3.8 27B со 128K токенов это 24,7 ГБ, и в 32 ГБ ОЗУ с нашим допущением они не помещаются.
На 16 ГБ ОЗУ остаются модели до 9B: Qwen3.5 4B, Llama 3.1 8B, Qwen3.5 9B и Qwen3 8B. Это только то, что поместится, а не то, что будет приятно работать. Модели MoE вроде Qwen3 Coder 30B-A3B (19,1 ГБ) читают на каждый токен лишь часть весов, поэтому на процессоре им обычно проще, чем плотной модели того же размера. Токенов в секунду мы не измеряли: для вашего процессора и скорости памяти проверьте сами.
Когда ОЗУ не хватает совсем
Если модель не поместилась даже в ОЗУ, Windows может начать выгружать память на диск. Компьютер зависнет, а ответы будут идти очень долго. Закройте браузер и лишние программы или возьмите модель поменьше.
Когда проще арендовать карту на 24 ГБ, чем менять свою
Аренда выгодна, пока вы пользуетесь большой моделью урывками. Qwen3.8 27B требует 17,2 ГБ — карту 24 ГБ, а GPT-OSS 20B — 12,6 ГБ и 16 ГБ. Такую карту нужно покупать целиком, а арендовать можно на час или на несколько минут.
- Берите аренду, если большая модель нужна несколько часов в неделю: для теста, для разового задания, для сравнения моделей.
- Покупайте или меняйте карту, если вы работаете с моделью каждый день по многу часов. Сравните цену карты в магазине с блоком цен ниже и посчитайте, сколько часов в месяц вы реально работаете.
- Оставьте свою карту, если хватает Qwen3.5 9B или Gemma 4 12B: эти модели помещаются в вашу видеопамять, а аренда добавит только лишние траты.
Проверьте свою модель в калькуляторе: выберите квантизацию и контекст, и он покажет память и подходящие карты из каталога.
Как запустить большую модель на арендованной карте
Сервер списывает деньги, пока он включён
Оплата идёт поминутно с запуска. Закончили проверку — остановите сервер. За остановленный сервер платите только за диск, а удалённый диск вернуть нельзя.
Выберите карту
Для Qwen3.8 27B нужна карта на 24 ГБ, для Qwen3 14B хватит 12 ГБ, например RTX 3060 12 ГБ. Больше памяти даёт RTX 4090.
Выберите шаблон
Для Qwen3.8 27B готов шаблон Qwen 3.8: чат и модель работают без настройки. Для остальных моделей — Open WebUI + Ollama: впишите тег в поле «Модель», например qwen3:14b или qwen3.5:9b.
Подождите 2–5 минут
Сервер запускается, а модель скачивается при первом старте.
Откройте чат
Кнопка Open WebUI на странице сервера открывает чат. Другую модель можно скачать там же или по SSH.
ollama pull qwen3.5:9bОстановите сервер
Оплата поминутная: остановленный сервер не тратит деньги на GPU, платите только за диск.
Как запустить модель вообще без своей видеокарты — в статье «Локальная нейросеть без мощного ПК». Какие модели брать в Ollama по ступеням памяти — в подборке Ollama.
Что может пойти не так
- Контекст растёт. Цифры выше — для 8K. С длинным контекстом кэш растёт, и модель, едва влезшая в карту, перестанет помещаться.
- Рассуждения занимают контекст. Qwen3 и Qwen3.5 по умолчанию сначала думают, и ответ получается длиннее. Это съедает память кэша.
- Теги Ollama — другие сборки. Размер тега в библиотеке Ollama немного отличается от файла GGUF в наших данных. Если расчёт впритык, берите карту следующей ступени.
- Видеопамять занята. Windows, браузер и игры держат часть VRAM. Закройте их перед запуском модели, иначе реальный запас будет меньше расчётного.
- Ноутбук с двумя картами. Убедитесь, что программа использует дискретную карту, а не встроенную.
Как мы считали
Веса — реальные размеры файлов GGUF на Hugging Face; GPT-OSS 20B — его родной MXFP4. Кэш контекста посчитан по config.json каждой модели, кэш в FP16. Служебная память CUDA — около 0,75 ГБ плюс буфер логитов. Карта подходит, если модель занимает не больше 97,5% её памяти. Для ОЗУ взята та же оценка и допущение 8 ГБ запаса под систему. 1 ГБ здесь — 1024³ байт. Данные на 2026-10-19; таблица на 35 моделей — в статье «Сколько видеопамяти нужно открытым LLM», семейство Qwen — в статье «Какую модель Qwen выбрать», калькулятор — на странице инструмента.
Вопросы и ответы
- Какая модель Qwen подойдёт для 32 ГБ ОЗУ?
- В 32 ГБ ОЗУ с запасом 8 ГБ под систему помещаются Qwen3 32B (21,4 ГБ), Qwen3 Coder 30B-A3B (19,1 ГБ), Qwen3 30B-A3B (19,1 ГБ), Qwen3.8 27B (17,2 ГБ) и Qwen3 14B (10,7 ГБ). Начните с Qwen3.8 27B, она самая новая в нашей таблице. Qwen3 Next 80B-A3B не помещается (46,5 ГБ). На процессоре модель работает заметно медленнее, чем на видеокарте, а цифр скорости у нас нет.
- Запустится ли Qwen 3.5 7B на RTX 3050 6 ГБ?
- Модели Qwen3.5 7B в нашей таблице нет, есть 4B и 9B. Qwen3.5 4B занимает 4,1 ГБ и помещается в 6 ГБ. Qwen3.5 9B в Q4_K_M требует 6,8 ГБ, ей нужна карта на 8 ГБ; в 6 ГБ она влезает только в Q2 (5,4 ГБ) с потерей качества.
- Что запустится на 12 ГБ видеопамяти?
- Целиком на 12 ГБ работают Qwen3.5 4B, Llama 3.1 8B, Qwen3.5 9B, Qwen3 8B, Gemma 4 12B и Qwen3 14B в Q4_K_M при контексте 8K. Самая тяжёлая из них, Qwen3 14B, занимает 10,7 ГБ, то есть почти всю карту. Для Qwen3.8 27B (17,2 ГБ) нужна карта на 24 ГБ.
- Сколько весят Qwen3 8B, Qwen 4B и Llama 3.1 8B в гигабайтах?
- В Q4_K_M файл Qwen3.5 4B весит 2,6 ГБ, Qwen3 8B — 4,7 ГБ, Llama 3.1 8B — 4,6 ГБ. Видеопамяти нужно больше: с кэшем контекста 8K это 4,1 ГБ, 6,8 ГБ и 6,6 ГБ. В Q8_0 Qwen3 8B требует 10,3 ГБ.
- Как узнать, сколько у меня видеопамяти?
- Откройте диспетчер задач (Ctrl+Shift+Esc), вкладку «Производительность», выберите видеокарту и найдите строку про выделенную память. Для карт NVIDIA есть команда nvidia-smi --query-gpu=name,memory.total --format=csv, она печатает объём в МиБ. «Общая память» — это обычная ОЗУ, видеопамятью она не считается.
- Можно ли запускать модель из оперативной памяти и какая будет скорость?
- Можно: llama.cpp и Ollama умеют держать часть слоёв в ОЗУ и считать их на процессоре, но это заметно медленнее, чем целиком на видеокарте. Своих замеров токенов в секунду для конкретных процессоров и карт, например i9 с RTX 4060, у нас нет, поэтому цифр не называем. Проверьте скорость на своей машине или арендуйте карту на несколько минут.


