9 мин чтения ·
Кодинг-агент на своей модели: OpenCode, Qwen Code и другие
Кодинг-агент на арендованной видеокарте: на контексте 64K Qwen 3.8 27B занимает 20,7 ГБ. Настройка OpenCode и Qwen Code, цена часа и что ломается.
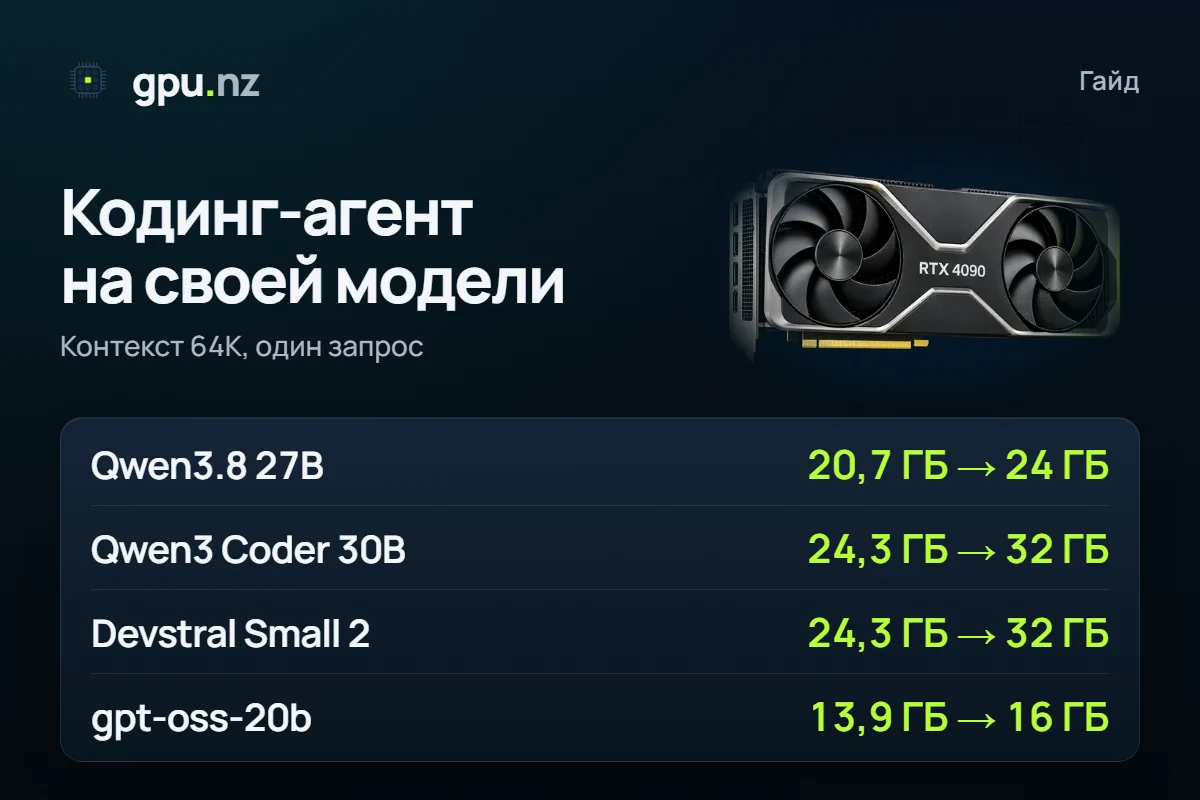
Кодинг-агенту на своей модели нужны видеокарта на 24 ГБ или больше, контекст от 64 тысяч токенов и модель, которая умеет вызывать инструменты. Qwen 3.8 27B с контекстом 64K занимает по расчёту 20,7 ГБ, Qwen3 Coder 30B-A3B — 24,3 ГБ. Ниже: какие агенты работают с чужой моделью, сколько памяти уходит на длинный контекст и два способа запуска.
- Qwen 3.8 27B, Q4_K_M, контекст 64K, кэш 16 бит
- 20,7 ГБ
- Qwen 3.8 27B, Q4_K_M, контекст 64K, кэш 16 бит
- Qwen3 Coder 30B-A3B, те же условия
- 24,3 ГБ
- Qwen3 Coder 30B-A3B, те же условия
- минимальный контекст для агентов по совету документации Ollama
- 64K
- минимальный контекст для агентов по совету документации Ollama
- от клика до первого ответа в нашем замере 2026-11-11 (один запуск)
- ~6,5 мин
- от клика до первого ответа в нашем замере 2026-11-11 (один запуск)
Что такое кодинг-агент и зачем ему своя модель
Кодинг-агент — программа на вашем компьютере. Она читает файлы проекта, запускает команды и тесты, правит код. Думает за неё языковая модель, к которой агент обращается по сети: это может быть чужой сервис по подписке или открытая модель на вашей арендованной видеокарте.
Названия легко спутать. Qwen Code — это агент для терминала, а Qwen3 Coder — семейство моделей для кода. Агент подойдёт к любой модели, если та отвечает по нужному протоколу и умеет вызывать инструменты.
Какие агенты умеют работать с чужой моделью
Почти все агенты говорят с моделью по OpenAI-совместимому протоколу, и это ровно то, что отдают наши шаблоны Ollama и vLLM. Исключение — Claude Code: он использует формат Anthropic. Что мы проверили сами, а что прочитали в документации — в последнем столбце.
| Агент | Что нужно своей модели и где это настраивается | Что проверено |
|---|---|---|
| OpenCode | Протокол OpenAI Chat Completions. В opencode.json — провайдер с пакетом @ai-sdk/openai-compatible, адресом baseURL и списком моделей | Документация на 2026-11-16. Наш замер 2026-11-11: OpenCode 1.19.5 и Qwen 3.8 27B в Ollama на RTX 4090, вызовы инструментов работали (один запуск) |
| Qwen Code | OpenAI-совместимый адрес. В ~/.qwen/settings.json — блок modelProviders с baseUrl и envKey; серверу нужны вызовы инструментов | Документация на 2026-11-16. Сами не запускали |
| Kimi Code CLI | Провайдер type = "openai" в ~/.kimi-code/config.toml: base_url, api_key, у модели — max_context_size | Документация на 2026-11-16. Сами не запускали |
| Claude Code | Формат Anthropic Messages, адрес задаёт переменная ANTHROPIC_BASE_URL | Anthropic пишет, что не поддерживает работу Claude Code с моделями не от Claude через шлюзы; Ollama описывает такую связку в своей документации. Мы не проверяли |
| gpu.nz Code | Ничего: приложение само арендует сервер, запускает модель и подключает агента | Наш замер 2026-11-11, тот же, что у OpenCode: приложение построено на нём |
Какую открытую модель взять для агента
Начните с Qwen 3.8 27B: это единственная модель, которую мы проверили с агентом, и она помещается в карту на 24 ГБ. Остальные ниже выбраны по размеру и назначению; качество мы не сравнивали, проверьте их на своих задачах.
- **Qwen 3.8 27B** — плотная модель, 27,78 млрд параметров, контекст до 256K. Её же приложение gpu.nz Code предлагает из коробки.
- **Qwen3 Coder 30B-A3B** — модель смеси экспертов для кода: 30,53 млрд параметров, около 3,3 млрд работают на каждый токен. Контекст до 256K.
- **Devstral Small 2 24B** — плотная, 24,01 млрд параметров, контекст до 384K. Кэш контекста у неё заметно тяжелее, чем у соседей.
- **GLM-4.7 Flash** — 31,22 млрд параметров, около 3 млрд активных, контекст до 198K.
- **GPT-OSS 20B** — 20,91 млрд параметров в родном формате MXFP4, самая лёгкая в списке: карта на 16 ГБ держит и контекст 64K.
Модели побольше упираются в число карт. Qwen3 Coder 480B-A35B в Q4_K_M с контекстом 64K занимает 286,7 ГБ: это минимум 4 × 80 ГБ. Kimi K2 от Moonshot AI — минимум 8 × 80 ГБ. Агент Kimi Code CLI это не ограничивает: его можно направить на любую модель из списка выше.
Главное условие — вызов инструментов. Агент не просто отвечает на вопросы: он просит модель «прочитать файл» или «выполнить команду». Если модель этого не умеет, агент не сможет работать с вашими файлами. Документация Qwen Code прямо требует включить вызов инструментов на сервере, а у OpenCode есть совет для Ollama: при проблемах с вызовами поднимите num_ctx до 16–32 тысяч токенов.
Сколько видеопамяти нужно агенту с длинным контекстом
Агент отправляет модели не вопрос, а всё накопленное: инструкции, куски файлов, вывод команд. Поэтому контекст в десятки тысяч токенов — норма, а кэш контекста растёт с каждым токеном. Документация Ollama советует для агентов и кодовых инструментов не меньше 64 тысяч токенов.
- Qwen 3.8 27B20,7 ГБ
- Qwen3 Coder 30B-A3B24,3 ГБ
- Devstral Small 2 24B24,3 ГБ
- GLM-4.7 Flash21,4 ГБ
- GPT-OSS 20B13,9 ГБ
Полная таблица: память на 32K, 64K и 128K токенов с обычным 16-битным кэшем и с 8-битным. Разница заметна у моделей с тяжёлым кэшем. Devstral Small 2 на 128K с 16-битным кэшем просит карту 48 ГБ, а с 8-битным — 32 ГБ.
| Модель | 32K | 64K | 128K | 64K, кэш 8 бит | 128K, кэш 8 бит |
|---|---|---|---|---|---|
| Qwen 3.8 27B | 18,7 ГБ карта 24 ГБ | 20,7 ГБ карта 24 ГБ | 24,7 ГБ карта 32 ГБ | 18,8 ГБ карта 24 ГБ | 20,9 ГБ карта 24 ГБ |
| Qwen3 Coder 30B-A3B | 21,3 ГБ карта 24 ГБ | 24,3 ГБ карта 32 ГБ | 30,3 ГБ карта 32 ГБ | 21,5 ГБ карта 24 ГБ | 24,7 ГБ карта 32 ГБ |
| Devstral Small 2 24B | 19,3 ГБ карта 24 ГБ | 24,3 ГБ карта 32 ГБ | 34,3 ГБ карта 48 ГБ | 19,7 ГБ карта 24 ГБ | 25,0 ГБ карта 32 ГБ |
| GLM-4.7 Flash | 19,8 ГБ карта 24 ГБ | 21,4 ГБ карта 24 ГБ | 24,7 ГБ карта 32 ГБ | 19,9 ГБ карта 24 ГБ | 21,6 ГБ карта 24 ГБ |
| GPT-OSS 20B | 13,2 ГБ карта 16 ГБ | 13,9 ГБ карта 16 ГБ | 15,4 ГБ карта 16 ГБ | 13,2 ГБ карта 16 ГБ | 14,0 ГБ карта 16 ГБ |
8-битный кэш занимает примерно вдвое меньше 16-битного при очень небольшой потере точности, так пишет документация Ollama. На 64K он сдвигает Qwen3 Coder 30B-A3B с карты 32 ГБ на 24 ГБ (24,3 ГБ против 21,5 ГБ). У Devstral Small 2 — тоже с карты 32 ГБ на 24 ГБ. В Ollama это три переменные сервера, а 8-битный кэш работает только вместе с flash attention:
OLLAMA_FLASH_ATTENTION=1
OLLAMA_KV_CACHE_TYPE=q8_0
OLLAMA_CONTEXT_LENGTH=65536Расчёт — нижняя граница. Для Qwen 3.8 27B на 64K калькулятор даёт 20,7 ГБ и карту 24 ГБ, но в нашем замере 2026-11-11 на RTX 4090 с обычным кэшем часть модели ушла на процессор. Скорость упала примерно на треть. С 8-битным кэшем (по расчёту 18,8 ГБ) модель осталась на видеокарте. Проверяйте командой ollama ps: в колонке PROCESSOR должно быть «100% GPU».
Контекст нужно задать самому: Ollama режет длинный запрос молча
В нашем замере 2026-11-11 Ollama обрезала запрос длиннее окна контекста без ошибки: ответ пришёл с кодом 200. Агент не узнает, что часть запроса потеряна, а сервер при этом оплачивается по минутам. По документации Ollama окно по умолчанию зависит от памяти: 4 тысячи токенов на картах меньше 24 ГиБ, 32 тысячи на 24–48 ГиБ. Шаблон Open WebUI + Ollama стартует с 8 тысячами, поэтому для агента задайте окно сами: OLLAMA_CONTEXT_LENGTH=65536 в Ollama или --max-model-len в vLLM.
Свою конфигурацию — модель, квантизацию и длину контекста — можно посчитать в калькуляторе:
Сколько стоит час и чем это отличается от подписки
Здесь нет цены за токен и лимитов на запросы: вы платите за минуты, пока сервер включён. Подписки на кодинг-сервисы устроены иначе: фиксированная плата за месяц и свои лимиты. Что выгоднее, зависит от того, сколько часов в месяц агент реально работает. Умножьте эти часы на цену часа из карточки ниже, а пока агент не нужен, останавливайте сервер.
Как направить агента на свой адрес
Нужны две вещи: адрес с /v1 и токен. В шаблонах Ollama это https://<id>-11434.run.gpu.nz/v1, в vLLM — https://<id>-8000.run.gpu.nz/v1, а токен лежит на странице сервера (подробнее — в гайде про Ollama и vLLM). Форматы ниже сверены с документацией 2026-11-16. У OpenCode с ноября две ветки, V1 и V2: V2 читает конфиг V1 как есть, поэтому один файл подходит обеим.
OpenCode: файл opencode.json в папке проекта или ~/.config/opencode/opencode.json. Токен берётся из переменной GPUNZ_TOKEN.
{
  "$schema": "https://opencode.ai/config.json",
  "model": "gpunz/qwen3.8:27b",
  "provider": {
    "gpunz": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "gpu.nz",
      "options": {
        "baseURL": "https://<id>-11434.run.gpu.nz/v1",
        "apiKey": "{env:GPUNZ_TOKEN}"
      },
      "models": {
        "qwen3.8:27b": {
          "name": "Qwen 3.8 27B",
          "limit": { "context": 65536, "output": 8192 }
        }
      }
    }
  }
}Qwen Code: файл ~/.qwen/settings.json. Переменная GPUNZ_TOKEN должна быть задана в окружении, в настройках её имя указано в envKey.
{
  "modelProviders": {
    "openai": [
      {
        "id": "qwen3.8:27b",
        "name": "Qwen 3.8 27B (gpu.nz)",
        "envKey": "GPUNZ_TOKEN",
        "baseUrl": "https://<id>-11434.run.gpu.nz/v1",
        "generationConfig": { "contextWindowSize": 65536 }
      }
    ]
  },
  "security": { "auth": { "selectedType": "openai" } },
  "model": { "name": "qwen3.8:27b" }
}Kimi Code CLI: файл ~/.kimi-code/config.toml. Возможности модели (capabilities) он по умолчанию угадывает по имени, поэтому для своей модели их лучше указать.
default_model = "gpunz"

[providers.gpunz]
type = "openai"
base_url = "https://<id>-11434.run.gpu.nz/v1"
api_key = "<token>"

[models."gpunz"]
provider = "gpunz"
model = "qwen3.8:27b"
max_context_size = 65536
capabilities = ["tool_use"]Способ 1: gpu.nz Code, без настройки
gpu.nz Code — наше бесплатное приложение с открытым кодом (MIT): кодинг-агент, который сам арендует сервер, запускает на нём открытую модель и подключается к ней. Оно построено на OpenCode и не связано с его командой. Работает в Windows, macOS и Linux.
Установите приложение и войдите
Скачайте сборку для своей системы на странице gpu.nz Code и войдите аккаунтом gpu.nz. На балансе должны быть деньги: сервер оплачивается с него.
Выберите модель
Qwen 3.8 27B проверена с агентом. Свою можно указать по имени из Ollama или ссылкой на GGUF с Hugging Face: приложение посчитает видеокарту и покажет цену часа до запуска. Сервер оно подбирает само.
Дождитесь запуска
Первый запуск обычно занимает 5–14 минут: сервер скачивает модель. В нашем замере 2026-11-11 от клика до первого ответа прошло около шести с половиной минут.
Откройте папку проекта и опишите задачу
Агент работает на вашем компьютере, проект никуда не загружается: на сервер уходят только запросы к модели. Перед деструктивными командами агент спрашивает разрешения.
Выберите автовыключение
Сервер удаляется после простоя 15, 30 или 60 минут и при выходе из приложения. Если отказались от автовыключения, удаляйте сервер сами. Подробности — в документации.
Способ 2: свой сервер и любой агент
Нужен другой агент или другая модель? Арендуйте сервер с шаблоном и подключите агента по адресу из раздела выше.
Скопируйте адрес и токен
На странице сервера кнопка «Ollama API» открывает список моделей; адрес до /v1 и токен вставьте в настройки агента.
Задайте контекст и проверьте его
В шаблоне Ollama задайте переменные из раздела про память. Через SSH выполните ollama ps: в колонке CONTEXT должно стоять ваше значение, в PROCESSOR — «100% GPU».
Вставьте настройки в агента
Конфиг OpenCode, Qwen Code или Kimi Code CLI из раздела выше; имя модели — как в списке «Ollama API».
Остановите сервер, когда закончили
Остановленный сервер не тратит деньги на видеокарту, платите только за диск.
На vLLM запуск выглядит так. Флаги вызова инструментов нужны агенту, а название парсера зависит от модели: возьмите его в документации vLLM по вызову инструментов.
vllm serve <model> --port 8000 --api-key <token> --max-model-len 65536 --enable-auto-tool-choice --tool-call-parser <parser>Что может пойти не так
- Часть модели ушла на процессор. Ответы стали медленнее примерно на треть, а ollama ps показывает долю CPU. Сожмите кэш до 8 бит, уменьшите контекст или возьмите карту побольше.
- Модель не вызывает инструменты. Агент отвечает текстом и не трогает файлы. В vLLM включите --enable-auto-tool-choice и парсер под свою модель. В OpenCode V2 найденные в vLLM модели стартуют с отключёнными инструментами, поэтому опишите модель в конфиге сами.
- Окно контекста меньше, чем думает агент. В настройках агента (limit.context, contextWindowSize, max_context_size) должно стоять то же число, что на сервере.
- Долгий первый запуск. Пока сервер скачивает модель, он уже оплачивается по минутам: те самые 5–14 минут.
- Забытый сервер. Агент молчит, а сервер работает. Включите автовыключение или остановите сервер вручную.
- Инструменты меняются быстро. Наш замер сделан на OpenCode 1.19.5, а на 2026-11-16 в репозитории проекта уже версия 2.3.0. Проверьте настройки по документации своей версии.
Как мы считали
Память посчитана калькулятором gpu.nz: веса — реальные размеры файлов, кэш контекста — по config.json каждой модели, 8-битный кэш — как 8,5 бита на значение. Данные на 2026-10-19. Один запрос, квантизация Q4_K_M, GPT-OSS 20B в родном MXFP4. 1 ГБ здесь — 1024³ байт, как у видеокарт. Подробнее о квантизации и кэше — в статье про GGUF, о памяти LLM — в таблице на 35 моделей.
Наш замер сделан 2026-11-11, один запуск каждого варианта, и мы его не обобщаем: OpenCode 1.19.5 с Qwen 3.8 27B в Ollama через OpenAI-совместимый адрес на арендованной RTX 4090. Вызовы инструментов работали; с контекстом 64K на карте 24 ГБ кэш пришлось сжать до 8 бит, чтобы модель осталась на видеокарте.
Настройки агентов и утверждения о них сверены 2026-11-16 с официальной документацией: opencode.ai/docs (V1 и V2), документация Qwen Code (qwenlm.github.io/qwen-code-docs), Kimi Code CLI (moonshotai.github.io/kimi-code), Claude Code (code.claude.com/docs, страница про шлюзы), Ollama (docs.ollama.com: context-length, faq, anthropic-compatibility) и vLLM (docs.vllm.ai, вызов инструментов). Qwen Code, Kimi Code CLI и Claude Code с нашими серверами мы не запускали; качество моделей не сравнивали. Цен в тексте нет: они в карточках.
Вопросы и ответы
- Как подключить OpenCode к своей модели в Ollama?
- В opencode.json добавьте провайдера с пакетом @ai-sdk/openai-compatible, адресом сервера с /v1 в options.baseURL и именем модели в разделе models. Если API закрыт токеном, укажите его в options.apiKey. Контекст в Ollama задайте не меньше 16–32 тысяч токенов, для агента лучше 64K.
- Какая модель подойдёт для OpenCode и Qwen Code на карте 24 ГБ?
- Qwen 3.8 27B: на контексте 64K она занимает 20,7 ГБ по расчёту и 18,8 ГБ с 8-битным кэшем. Qwen3 Coder 30B-A3B и Devstral Small 2 на 64K входят в 24 ГБ только с 8-битным кэшем: 21,5 ГБ и 19,7 ГБ.
- Сколько видеопамяти нужно кодинг-агенту с контекстом 64K?
- От 13,9 ГБ у GPT-OSS 20B до 24,3 ГБ у Qwen3 Coder 30B-A3B и Devstral Small 2 с обычным 16-битным кэшем. С 8-битным кэшем те же модели занимают 21,5 ГБ и 19,7 ГБ.
- Можно ли запустить Claude Code на своей открытой модели?
- Claude Code использует формат Anthropic Messages, адрес задаёт переменная ANTHROPIC_BASE_URL. Anthropic пишет, что не поддерживает работу Claude Code с моделями не от Claude через шлюзы, а Ollama описывает такую связку в своей документации. Мы её не проверяли и не обещаем, что она работает.
- Что такое Qwen Code и чем он отличается от Qwen3 Coder?
- Qwen Code — агент для терминала с лицензией Apache-2.0, а Qwen3 Coder — семейство моделей для кода. Агент можно направить на свой OpenAI-совместимый адрес, а модель запустить на арендованной видеокарте.
- Как запустить кодинг-агента без настройки сервера?
- Установите бесплатное приложение gpu.nz Code: оно само арендует сервер, запускает модель и подключает агента. Первый запуск занимает 5–14 минут, сервер оплачивается по минутам и удаляется после простоя, который вы выбрали: 15, 30 или 60 минут.


