10 мин чтения ·
Нейросеть для программирования: какую модель и видеокарту взять
Нейросеть для программирования на своём сервере: модели для кода занимают 18,7–21,3 ГБ в Q4 и идут на карте 24 ГБ. Чем чат отличается от агента и как выбрать.
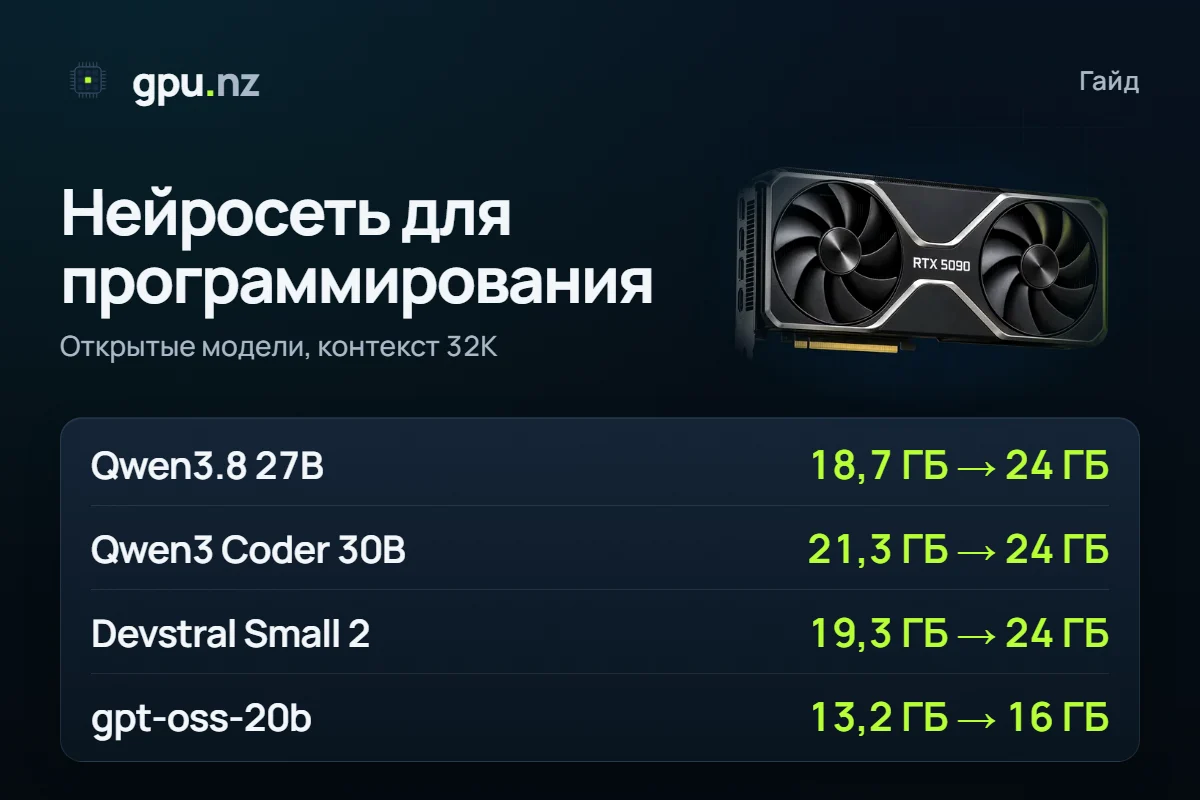
Нейросеть для программирования можно запустить у себя: открытая модель на 24–31 млрд параметров в квантизации Q4_K_M занимает 18,7–21,3 ГБ при контексте 32K и работает на видеокарте с 24 ГБ. Чат пишет код по вашему запросу, а агент сам читает проект, правит файлы и запускает тесты: для него важнее вызов инструментов и длинный контекст, чем размер модели. Ниже: как выбрать без рейтингов, таблица моделей, видеопамять, сравнение «купить или арендовать» и путь к первой задаче за 10–15 минут.
- gpt-oss-20b, MXFP4, контекст 32K — карта 16 ГБ
- 13,2 ГБ
- gpt-oss-20b, MXFP4, контекст 32K — карта 16 ГБ
- Qwen3.8 27B, Q4_K_M, контекст 32K — карта 24 ГБ
- 18,7 ГБ
- Qwen3.8 27B, Q4_K_M, контекст 32K — карта 24 ГБ
- Qwen3 Coder 30B-A3B, Q4_K_M, контекст 32K — карта 24 ГБ
- 21,3 ГБ
- Qwen3 Coder 30B-A3B, Q4_K_M, контекст 32K — карта 24 ГБ
- токенов контекста — минимум для кодинг-инструментов по документации Ollama
- 64 000
- токенов контекста — минимум для кодинг-инструментов по документации Ollama
Чем чат с кодом отличается от агента, который правит проект
Чат отвечает на вопрос: вы вставляете фрагмент, модель возвращает исправленный. Файлы вы копируете сами, и модель видит только то, что вы показали.
Агент работает сам. Он просит прочитать файл, ищет по проекту, правит несколько файлов, запускает тесты и смотрит на результат. Это называется вызовом инструментов: модель выдаёт команду, программа её выполняет и возвращает ответ.
Поэтому для ИИ-агента для программирования важны три вещи: модель умеет вызывать инструменты, держит длинный контекст (весь диалог с файлами и выводом команд) и остаётся на видеокарте целиком. Если часть модели уходит в обычную память, скорость заметно падает.
Как выбрать нейросеть для кода: четыре признака вместо рейтинга
Одной лучшей модели для кода нет: результаты в рейтингах публикуют сами авторы, а ваш проект на их задачи не похож. Выбирайте по четырём признакам, а потом проверьте две–три модели на своём коде.
- Размер и память. Он решает, какая видеокарта нужна: вес модели плюс кэш контекста. Модель MoE (смесь экспертов) занимает память всех параметров, но на каждый токен считает лишь часть, поэтому отвечает быстрее плотной модели того же размера.
- Контекст. Агенту нужно не меньше 64 000 токенов (так советует документация Ollama для кодинг-инструментов). Проверьте, сколько модель держит по карточке и сколько вы реально сможете позволить на своей карте.
- Вызов инструментов. Он должен быть в карточке модели, а не только «умеет писать код». Без него агент не получится.
- Лицензия. Apache 2.0 и MIT разрешают коммерческое использование. У части моделей лицензия своя, и её условия стоит прочитать до запуска в продукте.
Какие открытые модели сделаны для кода
В калькуляторе gpu.nz шесть моделей, которые их авторы описывают как модели для кода или для агентов. Лицензию и контекст мы прочитали на карточках моделей 2026-11-16. Память — расчёт по реальным файлам, один запрос.
| Модель | Параметры веса в Q4 | Контекст | Лицензия | Карта на 32K | Карта на 128K |
|---|---|---|---|---|---|
| Qwen3.8 27B | 27,8 млрд Q4_K_M 15,3 ГБ | 256K | Apache 2.0 | 24 ГБ | 32 ГБ |
| Qwen3 Coder 30B-A3B | 30,5 млрд активных 3,3 млрд Q4_K_M 17,3 ГБ | 256K | Apache 2.0 | 24 ГБ | 32 ГБ |
| Devstral Small 2 24B | 24,0 млрд Q4_K_M 13,3 ГБ | 256K | Apache 2.0 | 24 ГБ | 48 ГБ |
| GLM-4.7 Flash | 31,2 млрд активных 3,0 млрд Q4_K_M 17,1 ГБ | 198K | MIT | 24 ГБ | 32 ГБ |
| GPT-OSS 20B | 20,9 млрд активных 3,6 млрд MXFP4 11,3 ГБ | 128K | Apache 2.0 | 16 ГБ | 16 ГБ |
| Qwen3 Coder 480B-A35B | 480,2 млрд активных 35,0 млрд Q4_K_M 270,1 ГБ | 256K | Apache 2.0 | 4 × 80 ГБ | 4 × 80 ГБ |
- Qwen3.8 27B — плотная универсальная модель Alibaba на 27,8 млрд параметров. В карточке заявлены программирование и долгие агентные задачи, а ещё работа с картинками. Её мы проверили в агенте (замер ниже).
- Qwen3 Coder 30B-A3B — модель MoE, на каждый токен работают 3,3 млрд параметров. В карточке сказано про вызов функций и совместимость с Qwen Code и Cline. Если ищете «qwen coder», это она.
- Devstral Small 2 24B — модель Mistral AI для программной инженерии: в карточке она описана как агент, который изучает кодовую базу и правит несколько файлов. Официальный релиз — в FP8 (24,0 ГБ весов), в таблице считаем квантизацию Q4_K_M.
- GLM-4.7 Flash — модель MoE компании Z.ai под лицензией MIT. В карточке приведён запуск в vLLM с разбором вызовов инструментов (tool-call-parser).
- gpt-oss-20b — открытая модель OpenAI. В карточке указаны вызов функций и агентные задачи. Она выходит в формате MXFP4, поэтому ей хватает карты 16 ГБ.
- Qwen3 Coder 480B-A35B — старший брат из той же серии. Одной карте он не по силам: нужны 4 карты по 80 ГБ при контексте 32K и 4 при 128K.
DeepSeek Coder и Qwen2.5-Coder вышли в 2023–2024 годах, в калькуляторе их нет. У DeepSeek Coder своя лицензия (deepseek-license), её условия читайте отдельно. Про актуальные модели DeepSeek — в статье «DeepSeek V4 Flash», про семейство Qwen — в статье «Какую модель Qwen выбрать».
Сколько видеопамяти нужно для локальной нейросети для программирования
В Q4_K_M при контексте 32K 4 модели из 5 занимают 18,7–21,3 ГБ и помещаются в карту на 24 ГБ. Квантизация — это сжатие весов, Q4_K_M хранит около 4,8 бита на параметр вместо 16. К весам добавляется кэш контекста: чем длиннее разговор агента, тем он больше.
- Qwen3.8 27B18,7 ГБ
- Qwen3 Coder 30B-A3B21,3 ГБ
- Devstral Small 2 24B19,3 ГБ
- GLM-4.7 Flash19,8 ГБ
- GPT-OSS 20BMXFP413,2 ГБ
Агенту обычно нужно больше 32K. На 64K картина другая: на карте 24 ГБ остаются Qwen3.8 27B (20,7 ГБ) и GLM-4.7 Flash (21,4 ГБ), а Qwen3 Coder 30B-A3B (24,3 ГБ) и Devstral Small 2 (24,3 ГБ) просят карту 32 ГБ. Для 128K Qwen3.8 27B нужна карта 32 ГБ, Devstral Small 2 — 48 ГБ.
Эти цифры считают кэш контекста в 16 битах. Документация Ollama называет 8-битный кэш (OLLAMA_KV_CACHE_TYPE=q8_0) вдвое экономнее, с очень малой потерей точности. Наш замер 2026-11-11 (один запуск): Qwen3.8 27B через Ollama на RTX 4090 с контекстом 64K оставалась на GPU целиком только с 8-битным кэшем (q8_0 и OLLAMA_FLASH_ATTENTION=1). С кэшем по умолчанию часть модели ушла на процессор, и скорость упала примерно на треть. Калькулятор показывает для этого случая 20,7 ГБ: это около 88 % доступной памяти карты, запас небольшой, а у Ollama есть свои буферы.
Посчитайте свою модель и контекст
Выберите модель, квантизацию и длину контекста: калькулятор покажет память и карты каталога, на которых она запустится дешевле всего.
Хватит ли домашней видеокарты и когда аренда выгоднее покупки
Карта на 24 ГБ, например RTX 3090 или RTX 4090, держит 4 модели из таблицы с контекстом 32K. Карта на 16 ГБ подходит gpt-oss-20b (13,2 ГБ), остальные ей не по силам. На 12 ГБ и меньше ни одна модель из таблицы не помещается: берите меньшие, список — в статье «Лучшие модели для Ollama».
Если своей карты нет или нужен длинный контекст, арендуйте её на часы. Покупку и аренду сравнивайте без угадывания: разделите цену карты на цену часа из карточек ниже, получите число часов, после которого покупка окупается. Добавьте электричество и время простоя. Кто пишет код с агентом пару раз в неделю, может до этого числа не дойти.
Как попробовать за десять минут: gpu.nz Code
gpu.nz Code — наше бесплатное приложение с открытым исходным кодом (MIT, github.com/gpunz/gpunz-code). Это ИИ-агент для программирования на основе OpenCode: мы не связаны с командой OpenCode. Агент работает на вашем компьютере, а приложение само арендует сервер, запускает на нём модель и подключает агента.
Скачайте приложение
На странице gpu.nz Code выберите Windows, macOS или Linux. Подробности установки — в документации.
Войдите в аккаунт gpu.nz
Нажмите «Войти через gpu.nz» и подтвердите код в браузере. На балансе должны быть деньги: сервер оплачивается поминутно, без цены за токены и без лимита запросов.
Выберите модель
Начните с Qwen 3.8 27B: её мы проверили с агентом. Свою модель впишите по имени из Ollama или ссылкой на GGUF с Hugging Face и нажмите «Рассчитать»: приложение покажет нужную карту и цену часа до запуска.
Откройте папку проекта и поставьте задачу
Первый запуск занимает обычно 5–14 минут: сервер скачивает модель. В нашем запуске 2026-11-11 от нажатия до первого ответа прошло около шести с половиной минут. Проект на сервер не загружается, к модели уходят только запросы. Перед деструктивными командами агент спрашивает разрешения.
Выберите автовыключение
Сервер удаляется при простое через 15, 30 или 60 минут и при выходе из приложения. Если хост отказал, приложение берёт другой сервер.
Второй путь — чат без агента. Шаблон Qwen 3.8 даёт чат и API на карте с 24 ГБ: его хватит для вопросов и фрагментов кода, но шаблон рассчитан на контекст 16 384 токена, для агента мало. Другие модели из таблицы запускаются в шаблоне Ollama: впишите имя модели из библиотеки Ollama, например devstral-small-2:24b, qwen3-coder:30b, gpt-oss:20b или glm-4.7-flash (имена проверены на ollama.com 16.11.2026).
Модель без вызова инструментов только отвечает текстом
Агенту нужен вызов инструментов: без него модель не прочитает файл и не запустит команду, а просто напишет ответ. Для моделей из таблицы он описан в карточках, а для Qwen3.8 27B мы проверили его сами. Если вы подключили свою модель, приложение предупредит после запуска, умеет ли она вызывать инструменты. Но запуск уже оплачен по минутам, поэтому поищите в карточке слова tool calling или function calling до старта.
Что может пойти не так
- Ollama молча обрезает длинный запрос. В нашем замере 2026-11-11 запрос длиннее контекста вернул HTTP 200 без ошибки: модель просто не увидела начало. Документация Ollama: на карте до 24 ГиБ контекст по умолчанию 4K, при 24–48 ГиБ — 32K. Карта «на 24 ГБ» показывает чуть меньше 24 ГиБ, поэтому задайте контекст сами (OLLAMA_CONTEXT_LENGTH) и проверьте командой ollama ps.
- Часть модели ушла на процессор. Запуск идёт, но медленно. В столбце PROCESSOR команды ollama ps должно быть «100% GPU».
- Агент делает лишнее. Читайте команду перед тем, как разрешить её, особенно удаление и запись за пределами проекта. «Разрешить всегда» берите только для безопасных команд.
- Забытый сервер. Он оплачивается по минутам, пока существует. Автовыключение выручает, но не отменяет привычки проверить баланс.
- Слабая квантизация. Q2 и Q3 экономят память, но ответы хуже. Для кода начинайте с Q4_K_M, а потом смотрите на результат.
Как мы считали
Память — расчёт калькулятора по реальным файлам GGUF и архитектуре моделей: веса, кэш контекста в 16 битах, служебная память CUDA. 1 ГБ здесь — 1024³ байт, как у видеокарт. Данные на 2026-10-19. Лицензию мы взяли из шапки карточки модели на Hugging Face, контекст — из текста карточки, а где он не назван (GLM-4.7 Flash, gpt-oss-20b), из max_position_embeddings в config.json; всё прочитано 2026-11-16. Для Devstral Small 2 карточка называет 256K, config.json — 393 216 токенов. Умолчания и переменные Ollama взяты из его документации 2026-11-16. Замеры 2026-11-11 — один запуск OpenCode 1.19.5 с Qwen3.8 27B на RTX 4090 через совместимый с OpenAI адрес Ollama: вызовы инструментов работали. Это не бенчмарк, обобщать их не стоит. Качество моделей мы не сравнивали и не ранжировали. Таблица по 35 моделям — в статье «Сколько видеопамяти нужно открытым LLM».
Вопросы и ответы
- Какая нейросеть для кода лучше всего?
- Одной лучшей нет: выбирайте по размеру, контексту, вызову инструментов и лицензии, а потом проверьте две–три модели на своём коде. Для карты на 24 ГБ в калькуляторе gpu.nz подходят Qwen3.8 27B, Qwen3 Coder 30B-A3B, Devstral Small 2 и GLM-4.7 Flash, для карты на 16 ГБ — gpt-oss-20b.
- Чем ИИ-агент для программирования отличается от чата?
- Чат отвечает на вопрос, а агент сам читает файлы проекта, правит их и запускает тесты. Для этого модель должна уметь вызывать инструменты и держать длинный контекст.
- Сколько видеопамяти нужно для Qwen Coder и Devstral?
- В Q4_K_M при контексте 32K Qwen3 Coder 30B-A3B занимает 21,3 ГБ, Devstral Small 2 — 19,3 ГБ, обеим нужна карта 24 ГБ. При 64K они просят 32 ГБ.
- Есть ли замена DeepSeek Coder?
- DeepSeek Coder вышел в 2023–2024 годах, у него своя лицензия, и в калькуляторе gpu.nz его нет. Для кода есть более новые Qwen3 Coder, Devstral Small 2 и GLM-4.7 Flash, а у DeepSeek — модели V4 Flash и V3.2.
- Хватит ли домашней видеокарты для локальной нейросети для программирования?
- Карты на 24 ГБ хватит для 4 моделей из 5 с контекстом 32K, а для 64K и больше запас пропадает. Карта на 16 ГБ подходит только gpt-oss-20b (13,2 ГБ).
- Как попробовать ИИ для программирования без своей видеокарты?
- Скачайте бесплатное приложение gpu.nz Code, войдите в аккаунт gpu.nz и выберите модель. Приложение само арендует сервер с видеокартой; первый запуск занимает обычно 5–14 минут, оплата поминутная.


